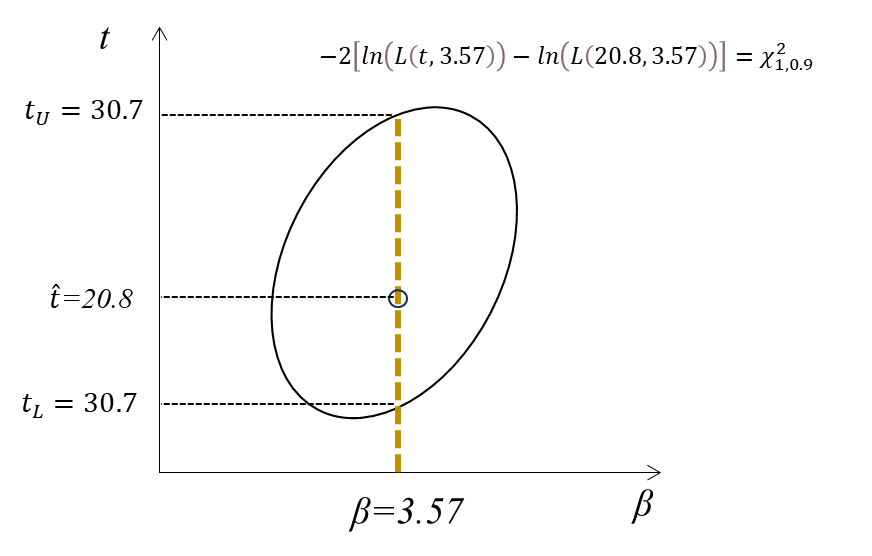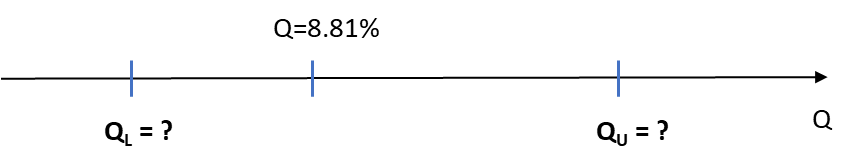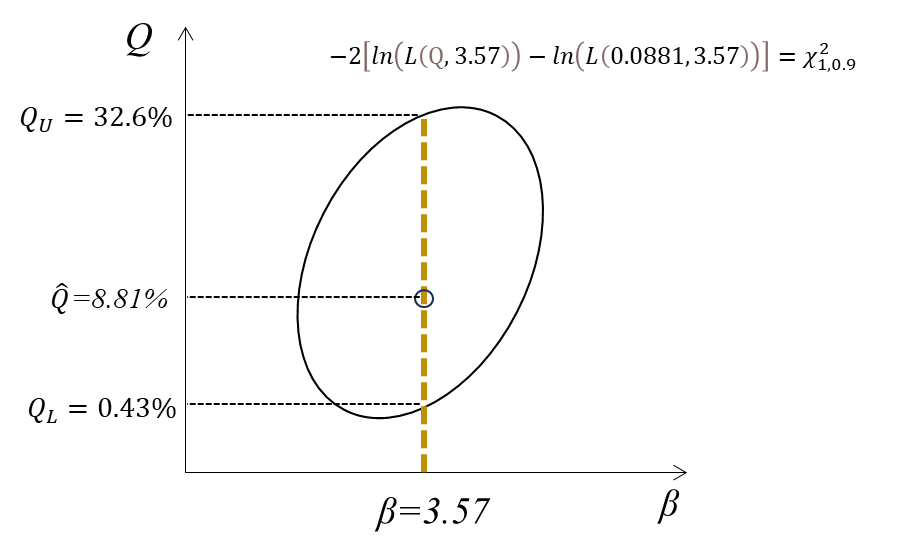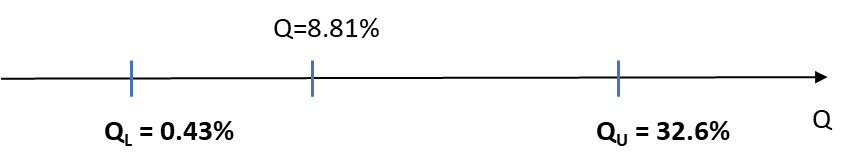可靠性数据分析 寿命数据分析(Life Data Analysis,LDA)也称为威布尔分析或可靠性分析,是用于评估产品或系统失效时间数据的统计方法。它帮助工程师和决策者了解产品在失效前可能运行多长时间,从而对可靠性、可维修性和性能作出有依据的预测。通过将寿命数据拟合至威布尔、指数或对数正态等概率分布,LDA 可以得到平均失效时间(MTTF)、失效率和随时间变化的可靠度等重要指标。这些信息可用于改进产品设计、保修规划和维修安排。
LDA 广泛应用于航空航天、制造、电子和能源等重视运行时间与安全性的行业。它通过量化失效行为和识别主要失效模式,支持以数据为依据的决策。LDA 不仅能够处理完整失效数据,也能处理删失(不完整)数据,例如试验结束时仍在运行的样品,或因其他原因退出观察的样品。因此,它为提高系统可靠性和优化寿命周期成本提供了灵活而有力的分析框架。
随机变量 是代表随机试验结果的数值。它为试验的各种可能结果赋予数值,使我们能够利用数学方法分析和描述不确定性。随机变量是概率论和统计学的基础,用于量化结果并计算其发生概率。
随机变量主要分为离散型 和连续型 两类。离散随机变量只能取可数的数值,例如试验中出现 0、1、2 或 3 次失效;它通常来自计数或分类过程。连续随机变量则可以在某个范围内取任意数值,例如某个部件的准确失效时间。连续变量通常通过测量得到,并以概率密度函数(PDF)描述;离散变量则使用概率质量函数(PMF)。
寿命数据分析只处理连续随机变量。
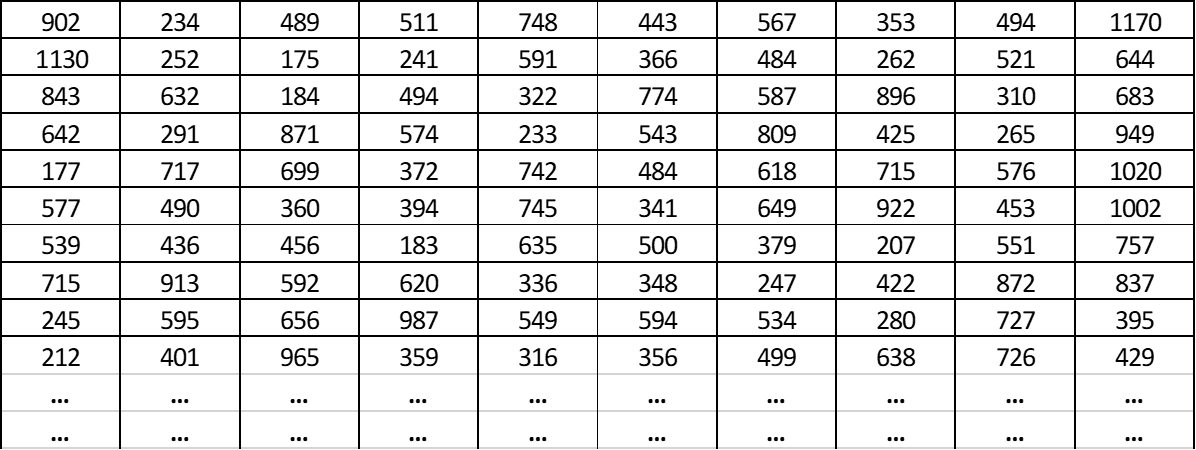
假设以下数据是 1,000 个轴承的失效时间(天)。
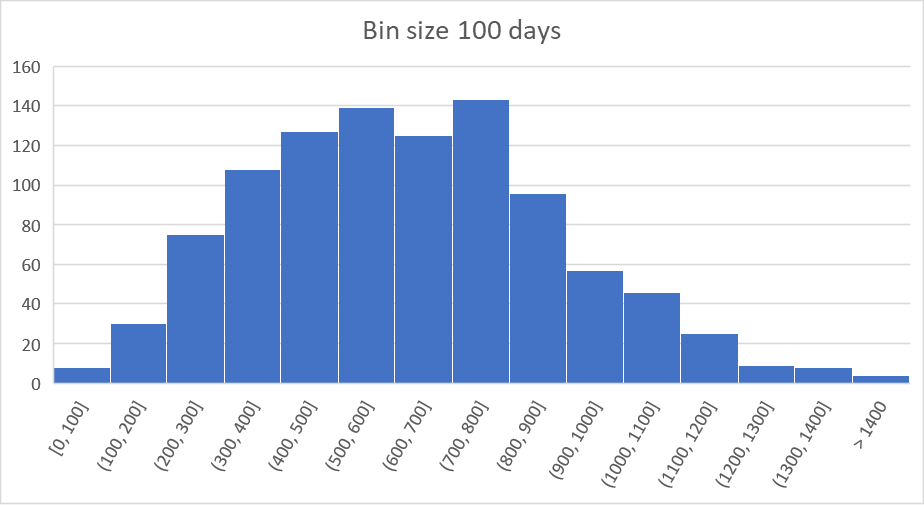
1,000 个轴承的失效时间 以 100 天为组距绘制直方图:
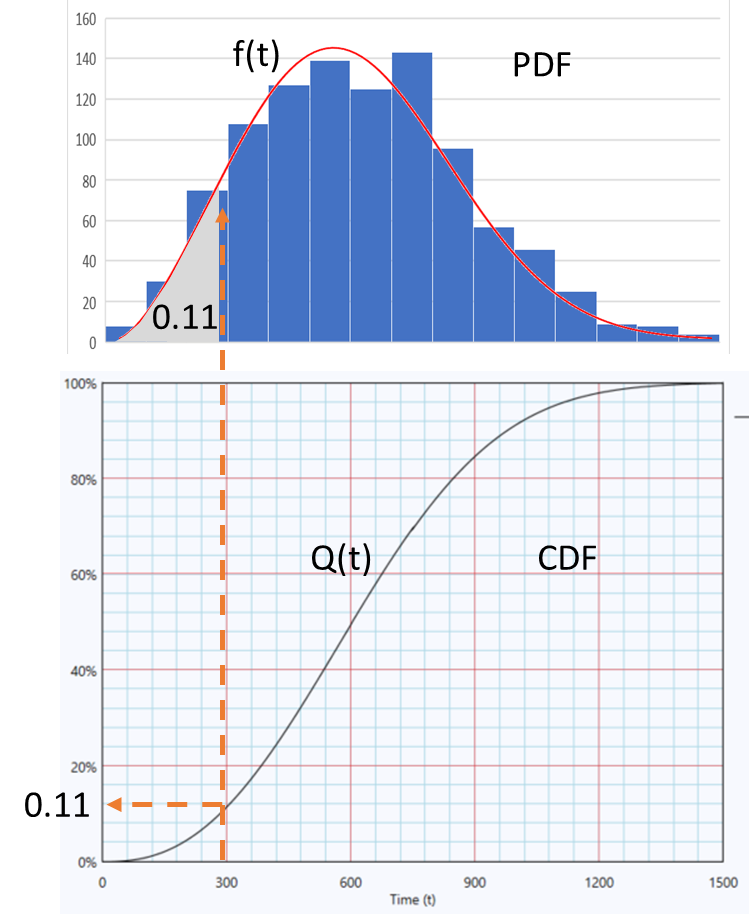
组距为 100 天的直方图 假设我们要估计运行至 300 天时总体中已经失效的百分比。300 天之前有三个柱,其高度分别为 6、31 和 74,合计得到 111 次失效。
样本总数为 1,000 个,因此轴承在运行 300 天内失效的概率为 0.111。请注意,以这个直方图只能按照 100 天的组距查询 100、200、300 天等时点的失效概率。
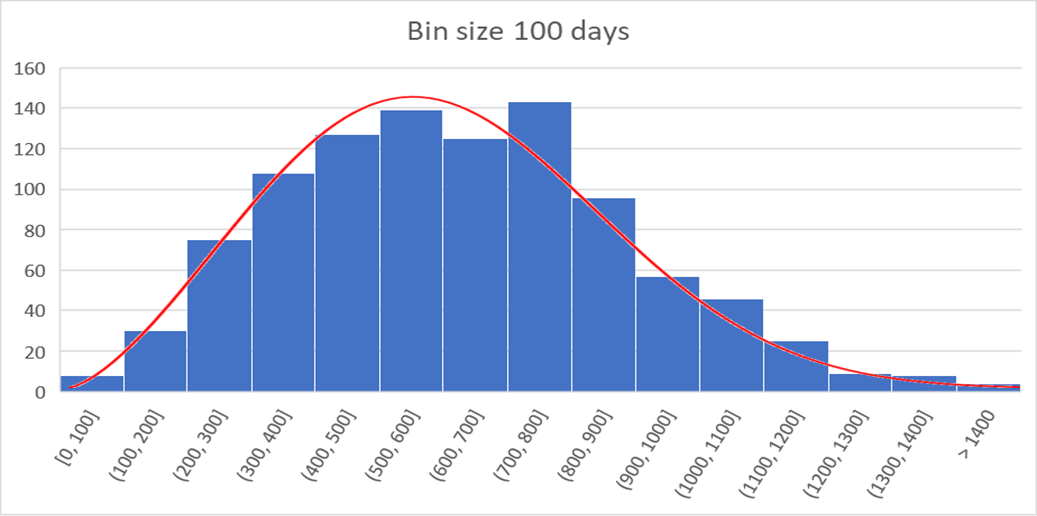
现在在直方图上叠加一条函数曲线:
在直方图上叠加概率密度曲线 该函数应具有以下特性:
函数轮廓反映并平滑各柱的数值。 函数曲线下的总面积等于 1。 有了这个函数,我们可以查询任意目标时间的失效概率。例如,将该函数从 0 积分至 150 天,即可求得 150 天内的失效概率。
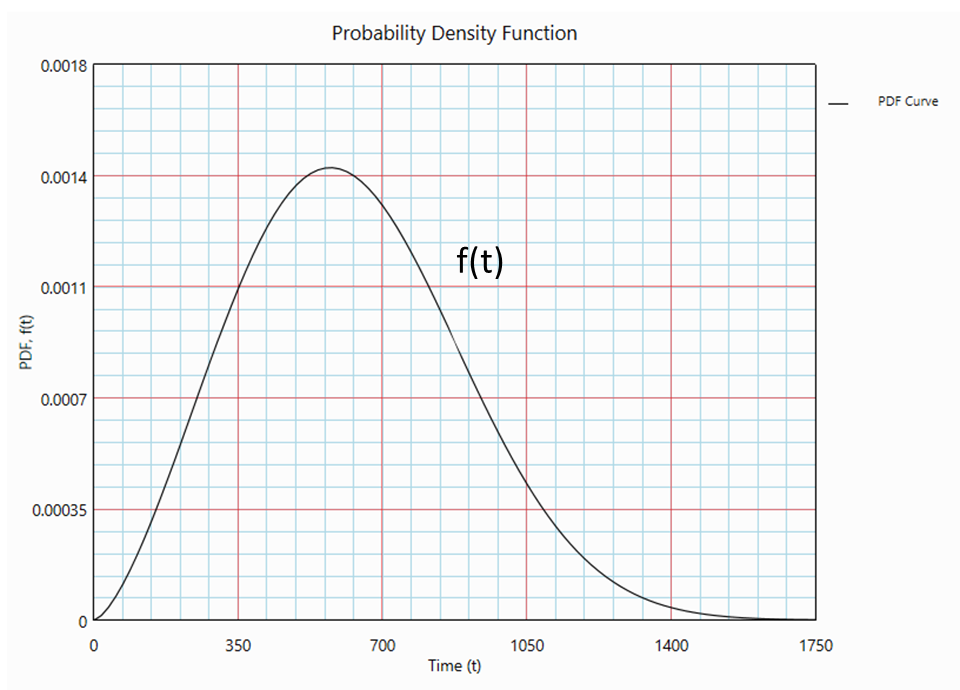
这个函数称为概率密度函数 (Probability Density Function,PDF),记为 f ( t ) f(t) f ( t )
概率密度函数 概率密度函数是描述连续随机变量在某一数值附近出现可能性的数学函数。变量落在指定区间内的概率,由 PDF 曲线在该区间下方的面积确定。整条 PDF 曲线下的总面积恒等于 1,表示变量必然在其定义域内取某个数值。
PDF 可以直观显示随机变量的分布,但要直接读取函数曲线截至某个时点的面积并不方便。累积分布函数(CDF)则允许我们直接读取时间 t t t
大多数经典统计教材以 F ( t ) F(t) F ( t ) Q ( t ) Q(t) Q ( t ) 不可靠度函数 。
如下图所示,可直接从 CDF 读取:Q ( t = 300 天 ) = 0.11 Q(t=300\text{ 天})=0.11 Q ( t = 300 天 ) = 0.11
从 CDF 和 PDF 读取失效概率 若从 PDF 读取该数值,必须求出 f ( t ) f(t) f ( t ) t = 0 t=0 t = 0 t = 300 t=300 t = 300
Q ( t 0 ) = P ( t ≤ t 0 ) = ∫ − ∞ t 0 f ( t ) d t Q(t_{0}) = P(t \leq t_{0}) = \int_{- \infty}^{t_{0}}{f(t)dt} Q ( t 0 ) = P ( t ≤ t 0 ) = ∫ − ∞ t 0 f ( t ) d t
反之,PDF 是 CDF 的导数:
f ( t ) = d ( Q ( t ) ) d t f(t) = \frac{d(Q(t))}{dt} f ( t ) = d t d ( Q ( t ))
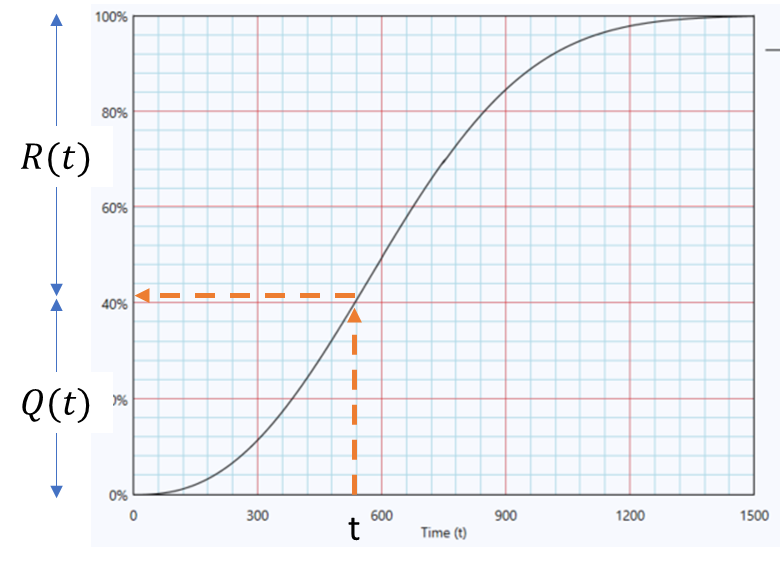
不可靠度图(CDF)允许用户直接读取时间 t t t t t t
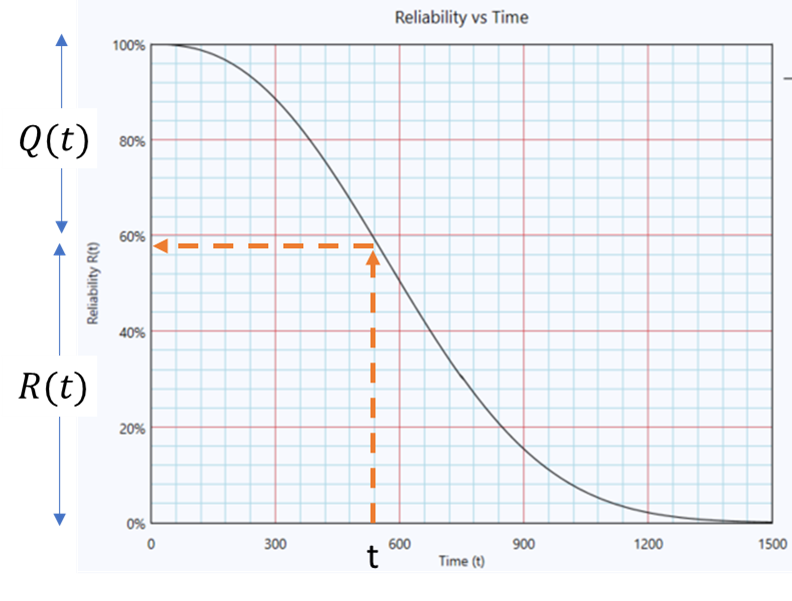
R ( t ) = 1 − Q ( t ) R(t) = 1 - Q(t) R ( t ) = 1 − Q ( t )
从不可靠度图读取可靠度 利用上述关系可以得到可靠度曲线。
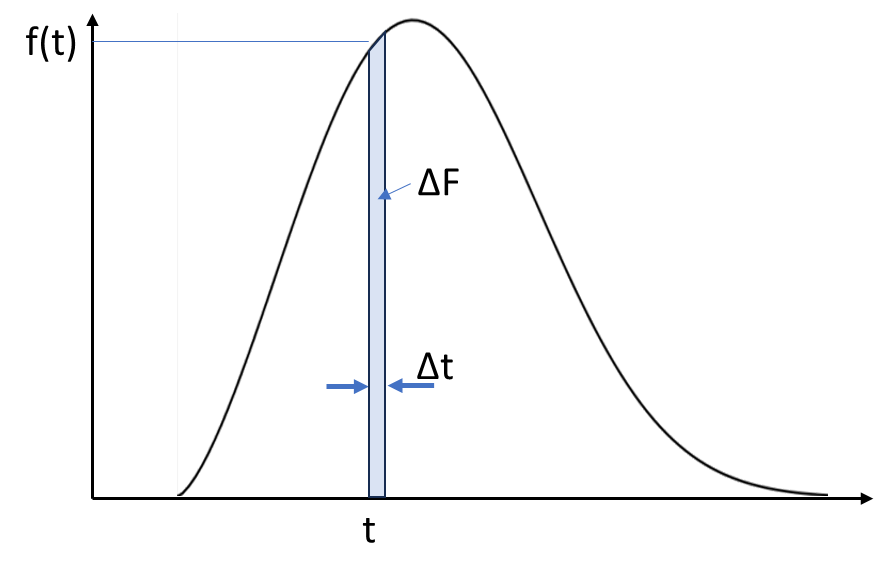
可靠度随时间变化曲线 数学上,时间 t t t λ ( t ) \lambda(t) λ ( t ) t t t
失效率示意图 根据定义:
λ ( t ) = Δ F N ( t ) Δ t = N 0 N ( t ) f ( t ) = N 0 N 0 ∙ R ( t ) f ( t ) = f ( t ) R ( t ) {\lambda(t) = \frac{\frac{\Delta F}{N(t)}}{\Delta t}
}{= \frac{N_{0}}{N(t)}f(t)
}{= \frac{N_{0}}{N_{0} \bullet R(t)}f(t)
}{= \frac{f(t)\text{~}}{R(t)}} λ ( t ) = Δ t N ( t ) Δ F = N ( t ) N 0 f ( t ) = N 0 ∙ R ( t ) N 0 f ( t ) = R ( t ) f ( t ) 其中,N ( t ) N(t) N ( t ) t t t N 0 N_{0} N 0
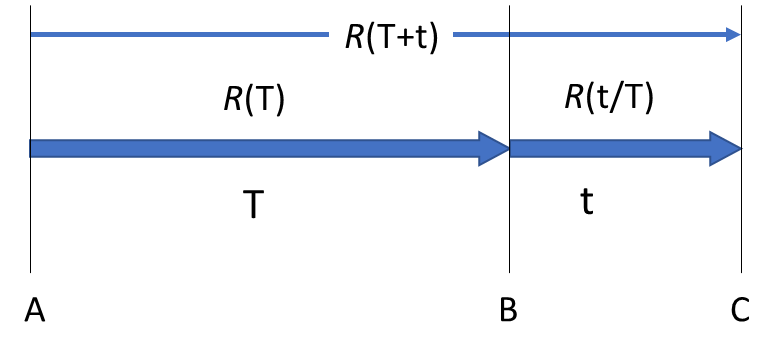
条件可靠度 R ( t / T ) R(t/T) R ( t / T ) T T T t t t
条件可靠度 要使某单元从 A 点存活至 C 点,它必须先从 A 点存活至 B 点,再从 B 点存活至 C 点。因此:
R ( T + t ) = R ( t T ) × R ( T ) ⇒ R ( t T ) = R ( T + t ) R ( T ) {R(T + t) = R\left( \frac{t}{T} \right) \times R(T)
}{\Rightarrow R(\frac{t}{T}) = \frac{R(T + t)}{R(T)}} R ( T + t ) = R ( T t ) × R ( T ) ⇒ R ( T t ) = R ( T ) R ( T + t ) 平均失效时间(MTTF)T ‾ \overline{T} T
T ‾ = ∫ 0 ∞ t ∙ f ( t ) d t \overline{T} = \int_{0}^{\infty}t \bullet f(t)dt T = ∫ 0 ∞ t ∙ f ( t ) d t
中位寿命 T ˘ \breve{T} T ˘
Q ( T ˘ ) = 0.5 Q\left( \breve{T} \right) = 0.5 Q ( T ˘ ) = 0.5
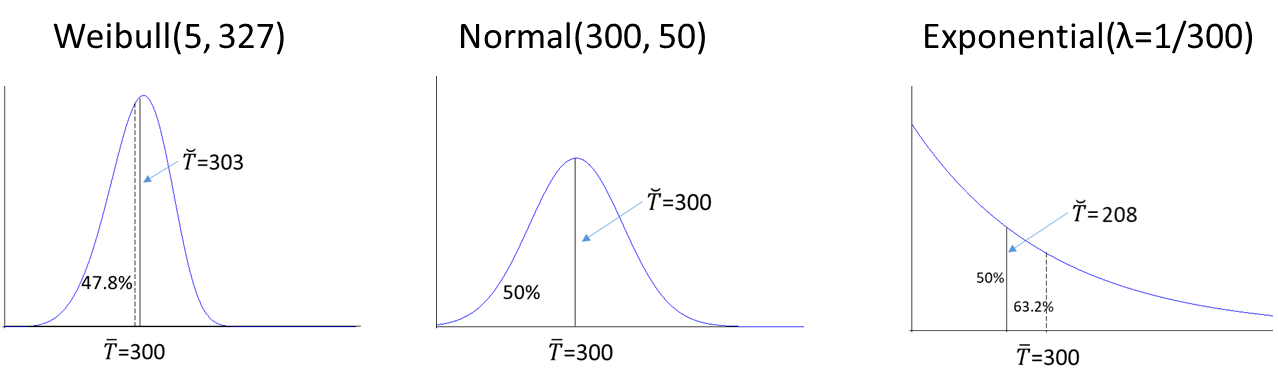
各种分布的均值与中位数 寿命数据分析使用以下主要数据类型:
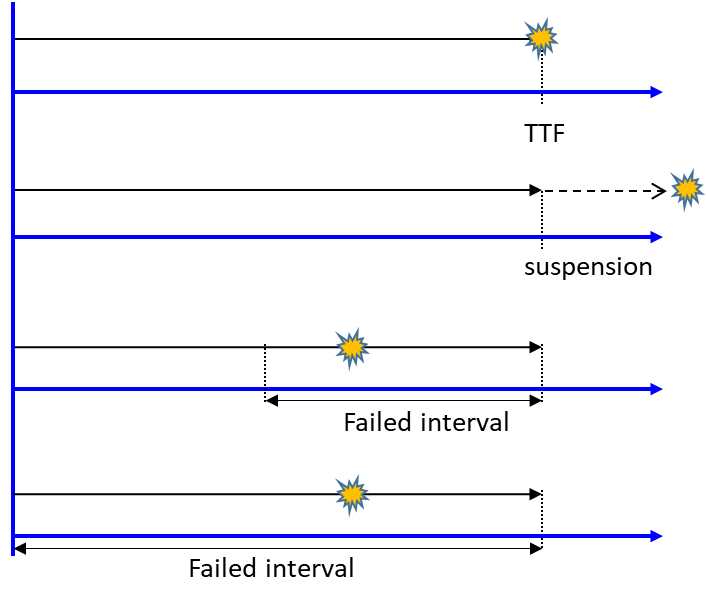
完整(失效)数据 :每个样品均观察至失效,准确失效时间已知。这是最直接的数据类型。右删失数据(暂停数据) :样品在观察期内没有失效,只知道它至少存活至某个时间。实际试验和现场数据中经常出现这种情况。区间删失数据 :准确失效时间未知,但已知失效发生在某个时间区间内,例如定期检查时发现样品在两次检查之间失效。左删失数据 :已知失效发生在某个时间之前,但没有观察到准确失效时间。
寿命数据分析使用的数据类型 这些数据类型可以共同用于估计寿命分布和可靠性指标。
分布模型用于从统计角度描述部件、系统或产品的失效时间。它帮助工程师了解潜在失效行为,例如失效是随机发生、随年龄增加,还是遵循某种退化模式。将合适的分布拟合至观测失效数据后,可以估计失效率、随时间变化的可靠度和平均失效时间等关键指标,从而支持设计、维修、保修预测和风险管理方面的决策。
指数分布通常用于描述随机且无记忆事件之间的时间,特别适用于失效率随时间保持恒定的情况。它结构简单,但在可靠性和生存分析中十分重要,并常被用作基准模型。
概率密度函数(PDF) 指数分布的 PDF 为:
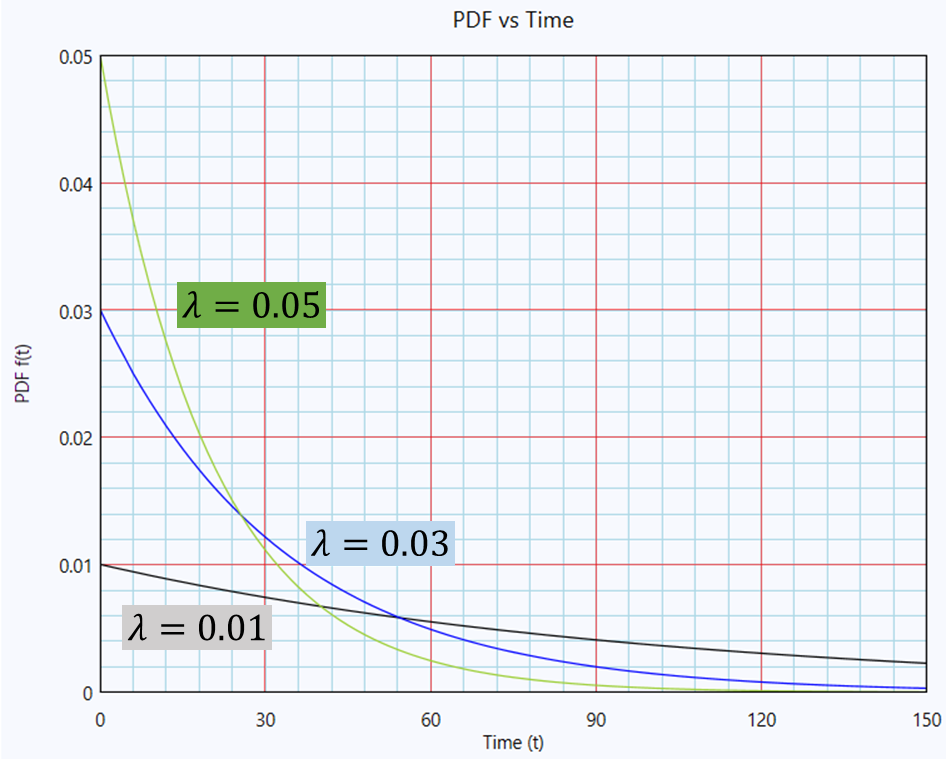
f ( t ) = λ e − λ t f(t) = {\lambda e}^{- \lambda t} f ( t ) = λ e − λ t
参数 lambda 对指数分布 PDF 的影响 当 λ \lambda λ
累积分布函数(CDF) Q ( t ) = ∫ 0 t f ( s ) d s = [ − e − λ s ] 0 t = 1 − e − λ t {Q(t) = \int_{0}^{t}{f(s)ds}
}{= \left\lbrack {- e}^{- \lambda s} \right\rbrack_{0}^{t}
}{= 1 - e^{- \lambda t}} Q ( t ) = ∫ 0 t f ( s ) d s = [ − e − λ s ] 0 t = 1 − e − λ t
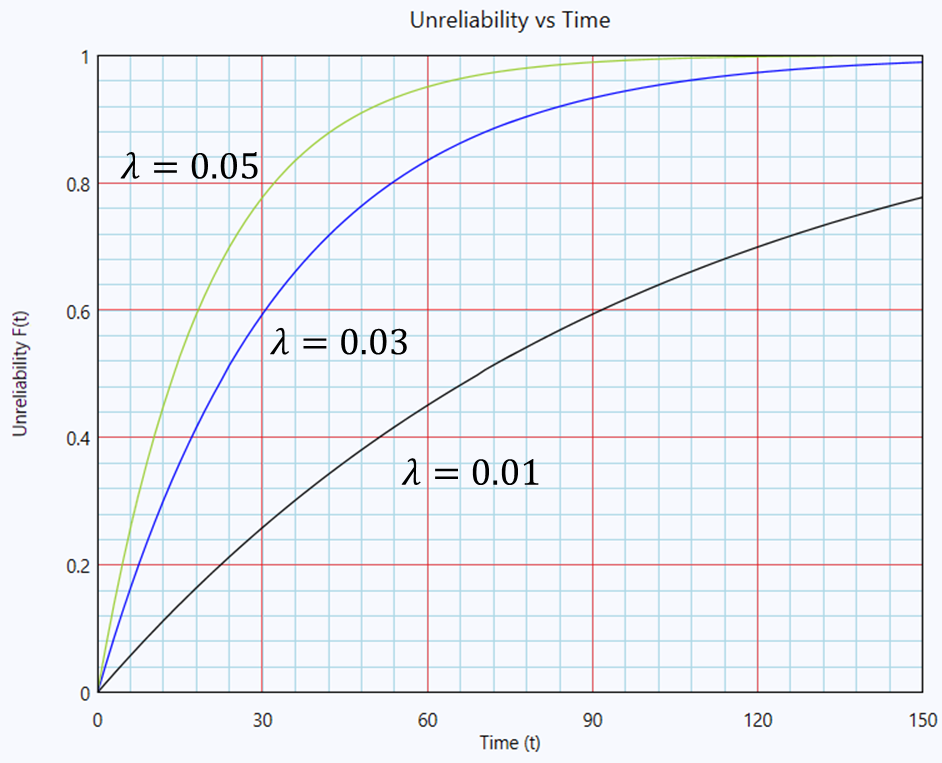
参数 lambda 对指数分布 CDF 的影响 当 λ \lambda λ
失效率函数 λ ( t ) = f ( t ) R ( t ) = λ e − λ t e − λ t = λ {\lambda(t) = \frac{f(t)}{R(t)}
}{= \frac{{\lambda e}^{- \lambda t}}{e^{- \lambda t}}
}{= \lambda} λ ( t ) = R ( t ) f ( t ) = e − λ t λ e − λ t = λ
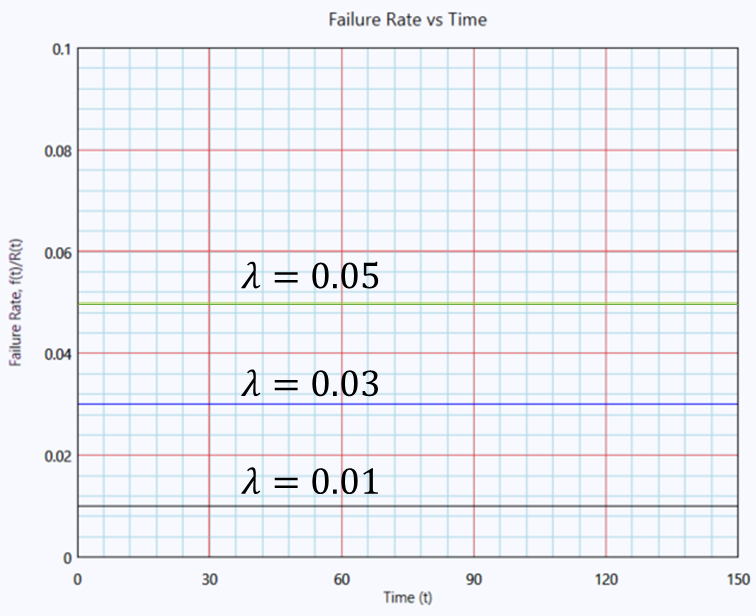
指数分布的失效率 平均失效时间(MTTF) T ‾ = ∫ 0 ∞ t f ( t ) d t = ∫ 0 ∞ t λ e − λ t d t = 1 λ {\overline{T} = \int_{0}^{\infty}{tf(t)dt}
}{= \int_{0}^{\infty}{t{\lambda e}^{- \lambda t}dt}
}{= \frac{1}{\lambda}} T = ∫ 0 ∞ t f ( t ) d t = ∫ 0 ∞ t λ e − λ t d t = λ 1 中位寿命 中位寿命 T ˘ \breve{T} T ˘
Q ( T ˘ ) = 0.5 1 − e − λ t = 0.5 T ˘ = − ln ( 0.5 ) λ {Q\left( \breve{T} \right) = 0.5
}{1 - e^{- \lambda t} = 0.5
}{\breve{T} = - \frac{\ln(0.5)}{\lambda}} Q ( T ˘ ) = 0.5 1 − e − λ t = 0.5 T ˘ = − λ ln ( 0.5 ) 威布尔分布常用于描述失效时间数据。它具有很高的灵活性,可通过形状参数 β \beta β
概率密度函数(PDF) 威布尔分布的 PDF 为:
f ( t ; β , η ) = β η ( t η ) β − 1 e − ( t η ) β f(t;\beta,\eta) = \frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1}e^{{- \left( \frac{t}{\eta} \right)}^{\beta}} f ( t ; β , η ) = η β ( η t ) β − 1 e − ( η t ) β
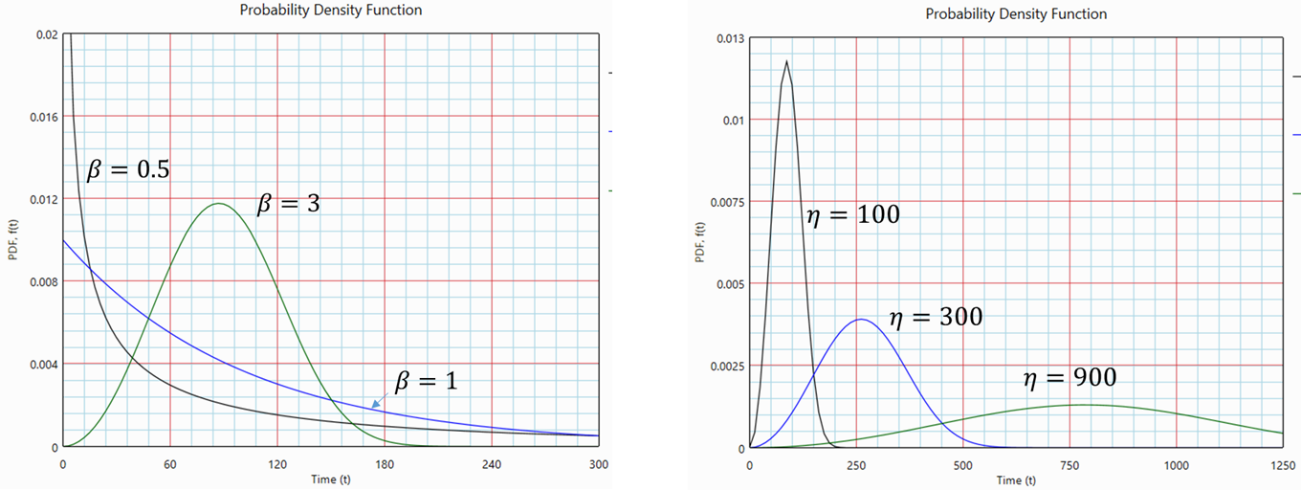
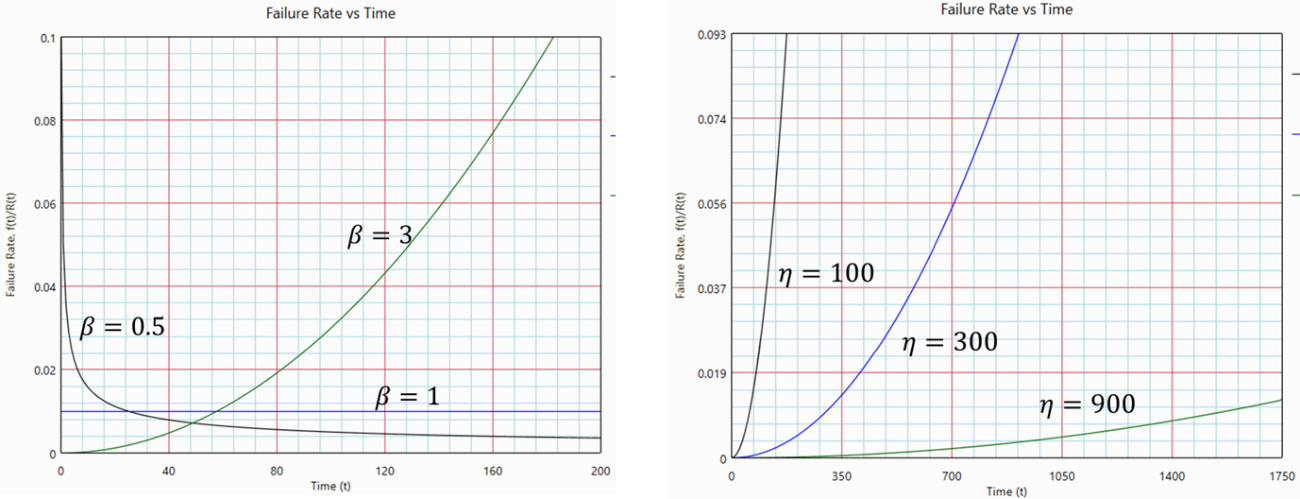
beta 和 eta 对威布尔分布 PDF 的影响 当 0 < β < 1 0 < \beta < 1 0 < β < 1 f ( t ) f(t) f ( t ) 当 β = 1 \beta = 1 β = 1 当 β > 1 \beta > 1 β > 1 f ( t ) f(t) f ( t ) 当 β \beta β η \eta η
累积分布函数(CDF) CDF 也称为不可靠度,通常记为 Q ( t ) Q(t) Q ( t ) F ( t ) F(t) F ( t )
Q ( t ; β , η ) = 1 − e − ( t η ) β Q(t;\beta,\eta) = 1 - e^{- \left( \frac{t}{\eta} \right)^{\beta}} Q ( t ; β , η ) = 1 − e − ( η t ) β
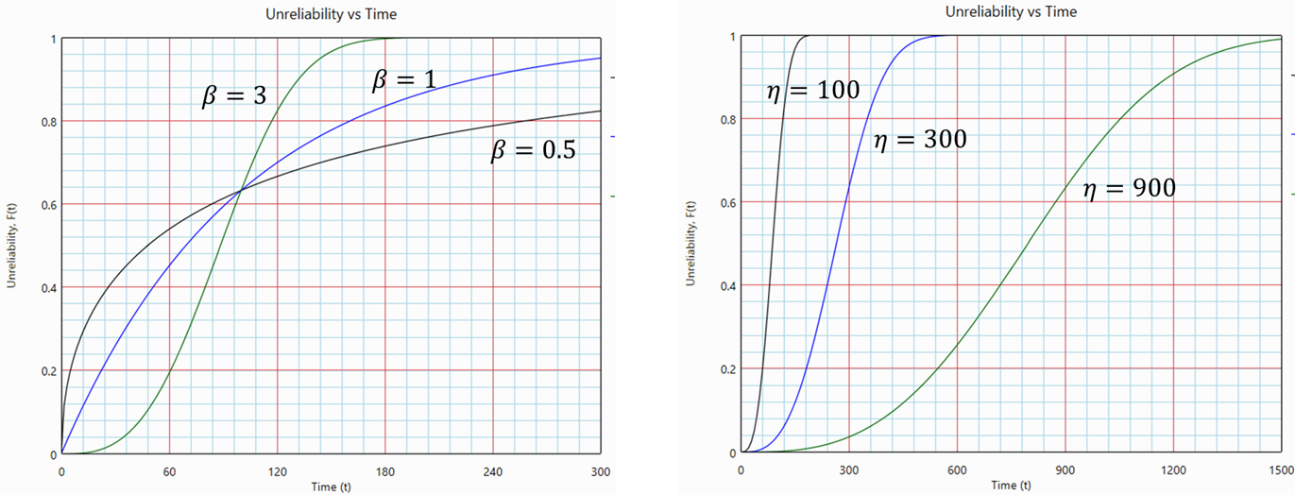
beta 和 eta 对威布尔分布 CDF 的影响 当 0 < β < 1 0 < \beta < 1 0 < β < 1 当 β = 1 \beta = 1 β = 1 当 β > 1 \beta > 1 β > 1 当 β \beta β η \eta η
失效率函数 失效率函数 λ ( t ) \lambda(t) λ ( t )
λ ( t ) = f ( t ) R ( t ) \lambda(t) = \frac{f(t)\text{~}}{R(t)} λ ( t ) = R ( t ) f ( t )
代入
f ( t ) = β η ( t η ) β − 1 e − ( t η ) β f(t) = \frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1}e^{{- \left( \frac{t}{\eta} \right)}^{\beta}} f ( t ) = η β ( η t ) β − 1 e − ( η t ) β
和 R ( t ) = e − ( t η ) β R(t) = e^{- \left( \frac{t}{\eta} \right)^{\beta}} R ( t ) = e − ( η t ) β
λ ( t ) = β η ( t η ) β − 1 e − ( t η ) β e − ( t η ) β = β η ( t η ) β − 1 {\lambda(t) = \frac{\frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1}e^{{- \left( \frac{t}{\eta} \right)}^{\beta}}}{e^{- \left( \frac{t}{\eta} \right)^{\beta}}}
}{= \frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1}} λ ( t ) = e − ( η t ) β η β ( η t ) β − 1 e − ( η t ) β = η β ( η t ) β − 1
beta 和 eta 对威布尔失效率函数的影响 当 0 < β < 1 0 < \beta < 1 0 < β < 1 当 β = 1 \beta = 1 β = 1 当 β > 1 \beta > 1 β > 1 减小 η \eta η t t t
平均失效时间(MTTF) 威布尔分布的均值为:
T ‾ = η ∙ Γ ( 1 β + 1 ) \overline{T} = \eta \bullet \Gamma\left( \frac{1}{\beta} + 1 \right) T = η ∙ Γ ( β 1 + 1 )
其中:
Γ ( n ) = ∫ 0 ∞ e − x x n − 1 d x \Gamma(n) = \int_{0}^{\infty}{e^{- x}x^{n - 1}dx} Γ ( n ) = ∫ 0 ∞ e − x x n − 1 d x
中位寿命 Q ( T ˘ ) = 0.5 1 − e − ( T ˘ η ) β = 0.5 T ˘ = η [ ln ( 2 ) ] 1 β {Q\left( \breve{T} \right) = 0.5
}{1 - e^{- \left( \frac{\breve{T}}{\eta} \right)^{\beta}} = 0.5
}{\breve{T} = \eta\left\lbrack \ln(2) \right\rbrack^{\frac{1}{\beta}}} Q ( T ˘ ) = 0.5 1 − e − ( η T ˘ ) β = 0.5 T ˘ = η [ ln ( 2 ) ] β 1 正态分布是一种对称的钟形概率分布,在统计学中应用广泛。由于它允许出现负值,而失效时间不可能为负,因此在寿命数据分析中不如威布尔或对数正态分布常用。但当变异较小且失效集中在某个中心值附近时,正态分布仍可能适用。
概率密度函数(PDF) 正态分布的 PDF 为:
f ( t ; μ , σ ) = 1 σ 2 π e − 1 2 ( t − μ σ ) 2 f(t;\mu,\sigma) = \frac{1}{\sigma\sqrt{2\pi}}e^{- \frac{1}{2}\left( \frac{t - \mu}{\sigma} \right)^{2}} f ( t ; μ , σ ) = σ 2 π 1 e − 2 1 ( σ t − μ ) 2
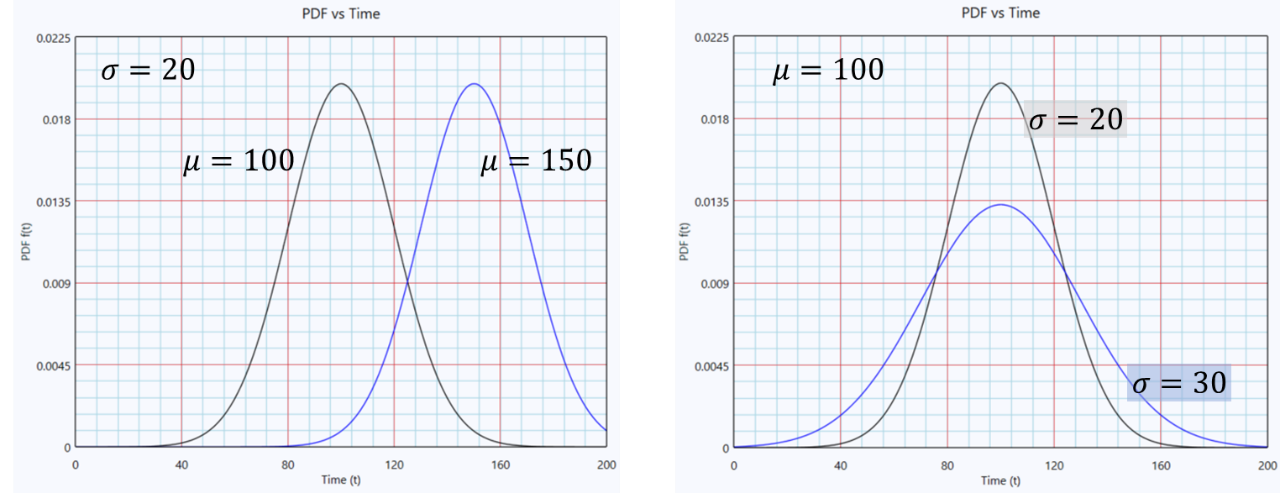
mu 和 sigma 对正态分布 PDF 的影响 μ \mu μ σ \sigma σ μ \mu μ
累积分布函数(CDF) Q ( t ) = 1 σ 2 π ∫ − ∞ t e − 1 2 ( x − μ σ ) 2 d x Q(t) = \frac{1}{\sigma\sqrt{2\pi}}\int_{- \infty}^{t}e^{- \frac{1}{2}\left( \frac{x - \mu}{\sigma} \right)^{2}}\mathbb{d}x Q ( t ) = σ 2 π 1 ∫ − ∞ t e − 2 1 ( σ x − μ ) 2 d x
正态 CDF 也可以用标准正态 CDF 表示:
Q ( t ) = Φ ( t − μ σ ) Q(t) = \Phi\left( \frac{t - \mu}{\sigma} \right) Q ( t ) = Φ ( σ t − μ )
其中,Φ ( ∙ ) \Phi(\bullet) Φ ( ∙ )
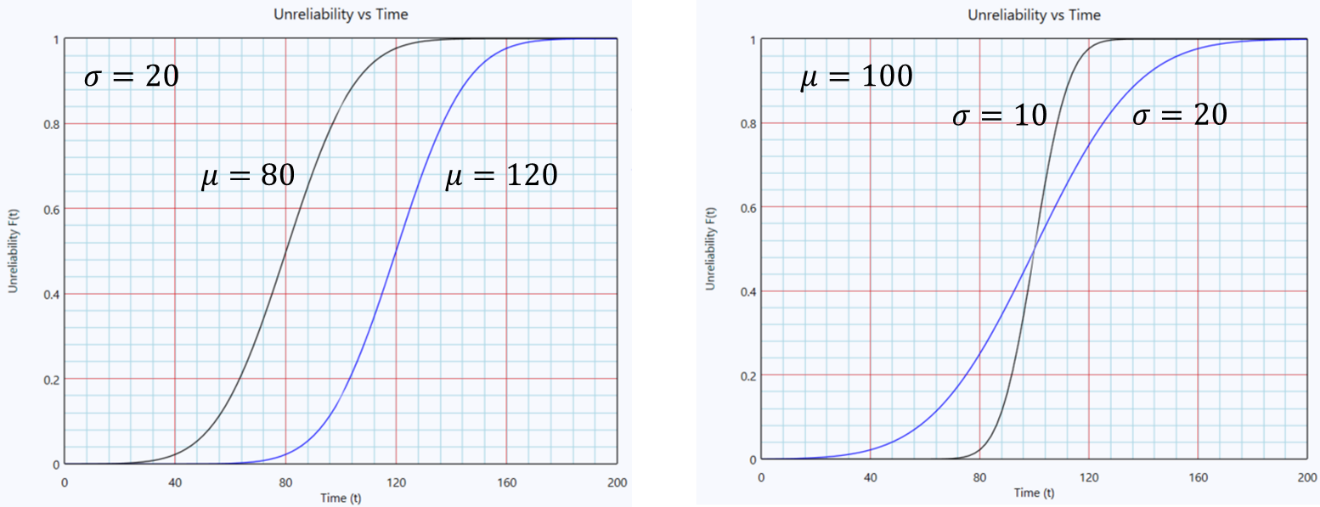
mu 和 sigma 对正态分布 CDF 的影响 失效率函数 正态分布的失效率为:
λ ( t ) = f ( t ) R ( t ) \lambda(t) = \frac{f(t)}{R(t)} λ ( t ) = R ( t ) f ( t )
其中:
f ( t ) = 1 σ 2 π e − 1 2 ( t − μ σ ) 2 f(t) = \frac{1}{\sigma\sqrt{2\pi}}e^{- \frac{1}{2}\left( \frac{t - \mu}{\sigma} \right)^{2}} f ( t ) = σ 2 π 1 e − 2 1 ( σ t − μ ) 2
R ( t ) = 1 − 1 σ 2 π ∫ − ∞ t e − 1 2 ( x − μ σ ) 2 d x R(t) = 1 - \frac{1}{\sigma\sqrt{2\pi}}\int_{- \infty}^{t}e^{- \frac{1}{2}\left( \frac{x - \mu}{\sigma} \right)^{2}}\mathbb{d}x R ( t ) = 1 − σ 2 π 1 ∫ − ∞ t e − 2 1 ( σ x − μ ) 2 d x
由于正态分布对称,中位数等于均值,也就是分布参数 μ \mu μ
T ‾ = T ˘ = μ \overline{T} = \breve{T} = \mu T = T ˘ = μ
对数正态分布用于描述其对数值服从正态分布的失效时间。它特别适用于失效机理由疲劳、腐蚀或化学分解等损伤或退化逐步累积所驱动的产品或系统。对数正态模型为右偏分布:多数单元在某一时间附近失效,但少数单元可以运行得更久。其特征是初始失效率较低,随后随时间上升,适合描述失效时间变异较大的磨损行为。
概率密度函数(PDF) 对数正态分布的 PDF 为:
f ( t ) = 1 t ∙ σ ′ 2 π e − 1 2 ( l n ( t ) − μ ′ σ ′ ) 2 f(t) = \frac{1}{{t \bullet \sigma}'\sqrt{2\pi}}e^{- \frac{1}{2}\left( \frac{ln(t) - \mu'}{\sigma'} \right)^{2}\text{~}} f ( t ) = t ∙ σ ′ 2 π 1 e − 2 1 ( σ ′ l n ( t ) − μ ′ ) 2
其中:
μ ′ \mu' μ ′ t t t σ ′ \sigma' σ ′ t t t
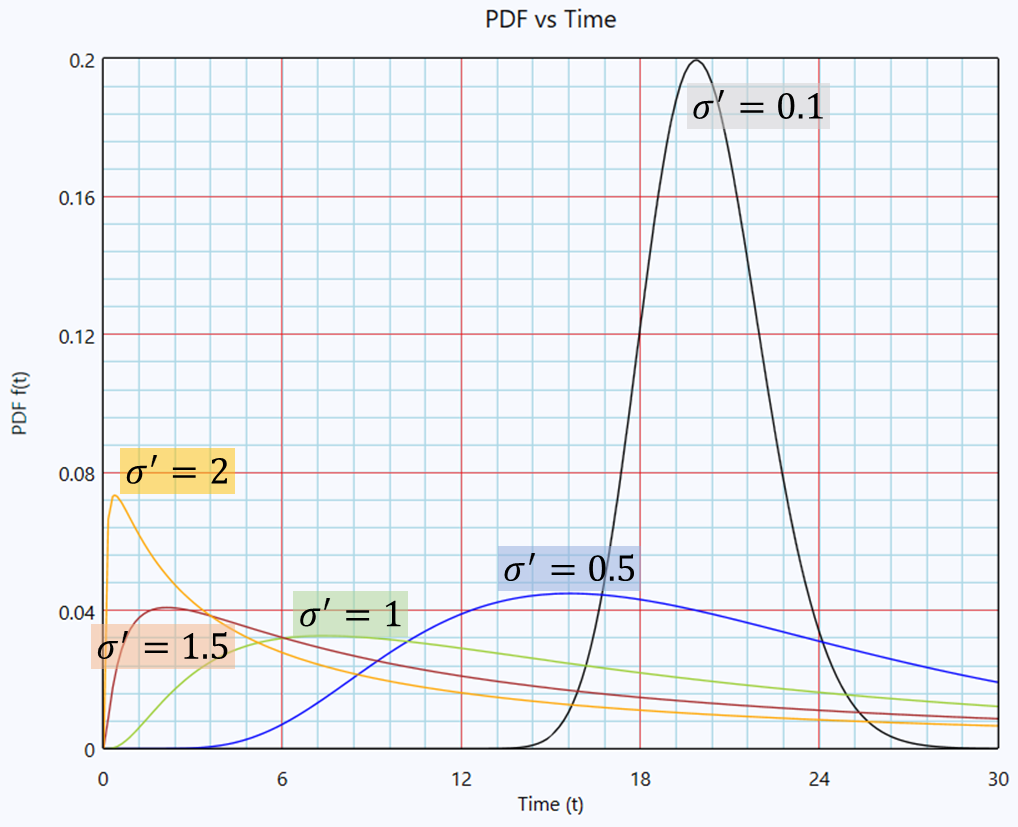
sigma 对对数正态分布 PDF 的影响 σ ′ \sigma' σ ′ σ ′ \sigma' σ ′ σ ′ \sigma' σ ′
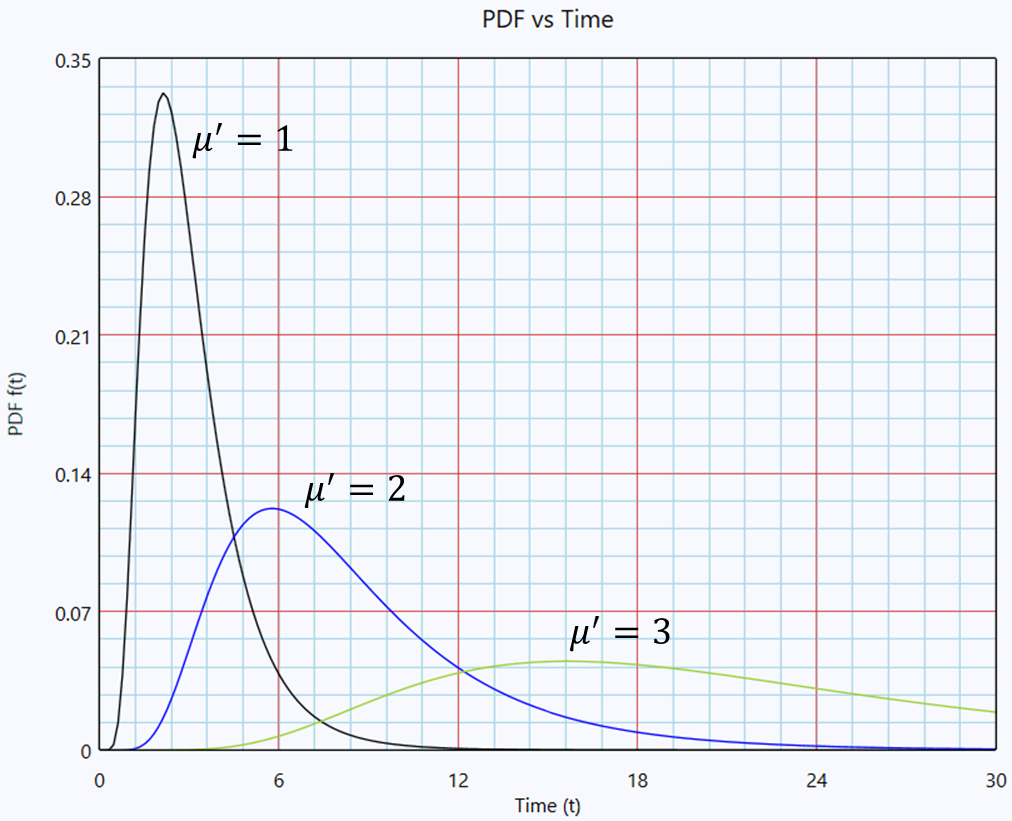
mu 对对数正态分布 PDF 的影响 μ ′ \mu' μ ′
累积分布函数(CDF) Q ( t ) = 1 t σ ′ 2 π ∫ 0 t e − 1 2 ( l n ( s ) − μ ′ σ ′ ) 2 d s Q(t) = \frac{1}{t\sigma'\sqrt{2\pi}}\int_{0}^{t}{e^{- \frac{1}{2}\left( \frac{ln(s) - \mu'}{\sigma'} \right)^{2}\text{~}}ds} Q ( t ) = t σ ′ 2 π 1 ∫ 0 t e − 2 1 ( σ ′ l n ( s ) − μ ′ ) 2 d s
也可以表示为:
Q ( t ) = Φ ( ln ( t ) − μ ′ σ ′ ) Q(t) = \Phi\left( \frac{\ln(t) - \mu'}{\sigma'} \right) Q ( t ) = Φ ( σ ′ l n ( t ) − μ ′ )
其中,Φ ( ∙ ) \Phi(\bullet) Φ ( ∙ )
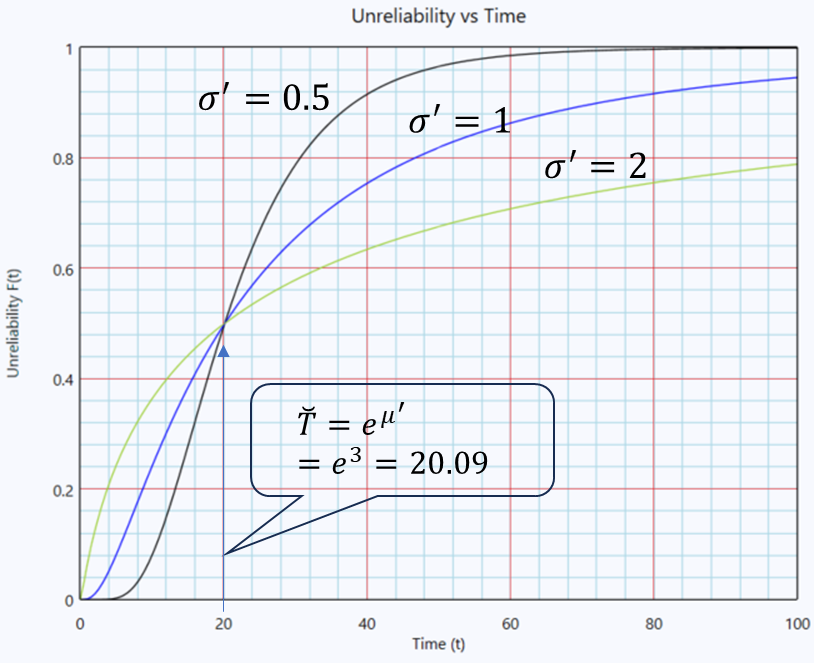
sigma 对对数正态分布 CDF 的影响 较大的 σ ′ \sigma' σ ′ σ ′ \sigma' σ ′
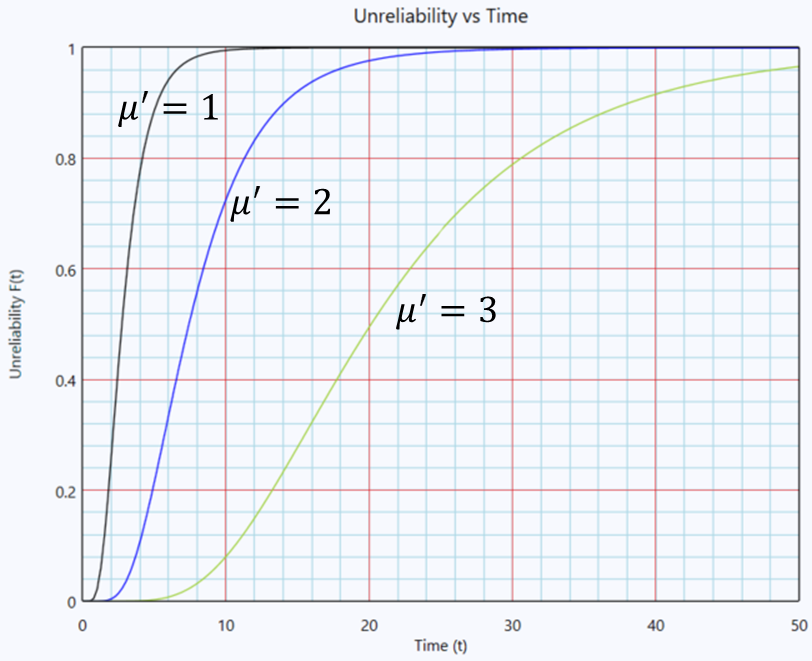
mu 对对数正态分布 CDF 的影响 μ ′ \mu' μ ′
失效率函数 对数正态分布的失效率为:
λ ( t ) = f ( t ) R ( t ) \lambda(t) = \frac{f(t)}{R(t)} λ ( t ) = R ( t ) f ( t )
其中:
f ( t ) = 1 t ∙ σ ′ 2 π e − 1 2 ( l n ( t ) − μ ′ σ ′ ) 2 f(t) = \frac{1}{{t \bullet \sigma}'\sqrt{2\pi}}e^{- \frac{1}{2}\left( \frac{ln(t) - \mu'}{\sigma'} \right)^{2}\text{~}} f ( t ) = t ∙ σ ′ 2 π 1 e − 2 1 ( σ ′ l n ( t ) − μ ′ ) 2
R ( t ) = 1 − 1 t σ ′ 2 π ∫ 0 t e − 1 2 ( ln ( s ) − μ ′ σ ′ ) 2 d s R(t) = 1 - \frac{1}{t\sigma^{'\sqrt{2\pi}}}\int_{0}^{t}{e^{- \frac{1}{2}\left( \frac{\ln(s) - \mu'}{\sigma'} \right)^{2}\text{~}}ds} R ( t ) = 1 − t σ ′ 2 π 1 ∫ 0 t e − 2 1 ( σ ′ l n ( s ) − μ ′ ) 2 d s
平均失效时间(MTTF) T ‾ = ∫ 0 ∞ t f ( t ) d t = ∫ 0 ∞ t 1 t ∙ σ ′ 2 π e − 1 2 ( l n ( t ) − μ ′ σ ′ ) 2 d t = 1 σ ′ 2 π ∫ 0 ∞ e − 1 2 ( l n ( t ) − μ ′ σ ′ ) 2 d t {\overline{T} = \int_{0}^{\infty}{tf(t)dt}
}{= \int_{0}^{\infty}{t\frac{1}{{t \bullet \sigma}'\sqrt{2\pi}}e^{- \frac{1}{2}\left( \frac{ln(t) - \mu'}{\sigma'} \right)^{2}\text{~}}dt}
}{= \frac{1}{\sigma'\sqrt{2\pi}}\int_{0}^{\infty}{e^{- \frac{1}{2}\left( \frac{ln(t) - \mu'}{\sigma'} \right)^{2}\text{~}}dt}} T = ∫ 0 ∞ t f ( t ) d t = ∫ 0 ∞ t t ∙ σ ′ 2 π 1 e − 2 1 ( σ ′ l n ( t ) − μ ′ ) 2 d t = σ ′ 2 π 1 ∫ 0 ∞ e − 2 1 ( σ ′ l n ( t ) − μ ′ ) 2 d t 该积分在统计学中的已知结果为:
T ‾ = e μ + 1 2 σ ′ 2 \overline{T} = e^{\mu + \frac{1}{2}{\sigma'}^{2}} T = e μ + 2 1 σ ′ 2
中位寿命 Q ( T ˘ ) = Φ ( ln ( T ˘ ) − μ ′ σ ′ ) = 0.5 Q\left( \breve{T} \right) = \Phi\left( \frac{\ln\left( \breve{T} \right) - \mu'}{\sigma'} \right) = 0.5 Q ( T ˘ ) = Φ ( σ ′ l n ( T ˘ ) − μ ′ ) = 0.5
由于 Φ ( 0 ) = 0.5 \Phi(0)=0.5 Φ ( 0 ) = 0.5
ln ( T ˘ ) − μ ′ σ ′ = 0 T ˘ = e μ {\frac{\ln\left( \breve{T} \right) - \mu'}{\sigma'} = 0
}{\breve{T} = e^{\mu}} σ ′ ln ( T ˘ ) − μ ′ = 0 T ˘ = e μ 参数估计的目的是确定最能描述一组观测数据的分布参数值。以下介绍两种常用方法:概率图法和极大似然估计(MLE)。它们常用于利用样本数据拟合威布尔、对数正态、正态和指数等参数分布。
概率图法是一种以图形方式估计理论概率分布参数(例如均值、标准差和形状参数)的方法,使所选分布尽可能拟合给定数据。
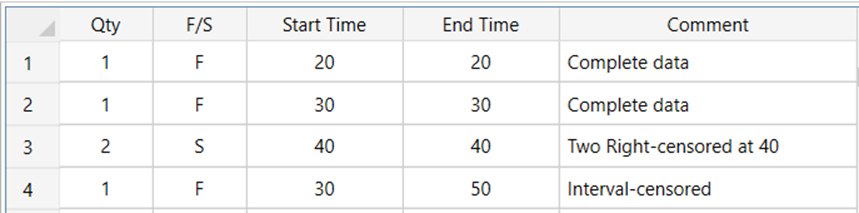
以下使用数据集 {30, 40, 20, 50} 说明。首先对失效数据排序,得到 {20, 30, 40, 50}。
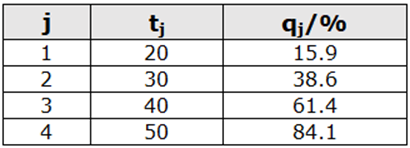
对于每个失效时间 t i t_i t i q i q_i q i
0.5 = ∑ k = j N ( N k ) q k ( 1 − q ) N − k 0.5 = \sum_{k = j}^{N}{\binom{N}{k}q^{k}(1 - q)^{N - k}} 0.5 = ∑ k = j N ( k N ) q k ( 1 − q ) N − k
秩位置 每个 t j t_j t j q j q_j q j
以下各节说明如何建立概率纸,并求解指数、威布尔、正态和对数正态分布的参数。
指数分布 指数分布的 CDF 为:
F ( t ) = 1 − e − λ t 1 − F ( t ) = e − λ t R ( t ) = e − λ t {F(t) = 1 - e^{- \lambda t}
}{1 - F(t) = e^{- \lambda t}
}{R(t) = e^{- \lambda t}} F ( t ) = 1 − e − λ t 1 − F ( t ) = e − λ t R ( t ) = e − λ t 两边取自然对数:
ln ( R ( t ) ) = − λ t \ln\left( R(t) \right) = - \lambda t ln ( R ( t ) ) = − λ t
因此,ln ( R ( t ) ) \ln(R(t)) ln ( R ( t )) t t t − λ -\lambda − λ
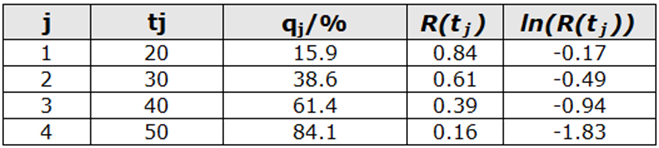
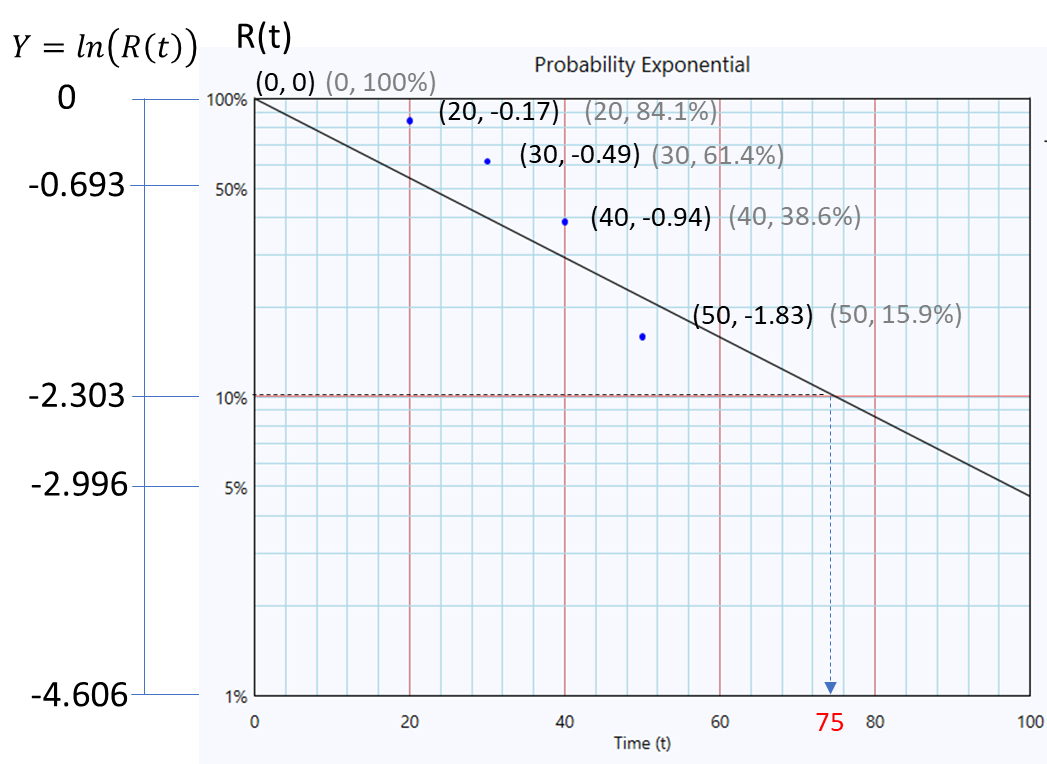
计算各失效时间对应的 ln(R(t)) 将坐标 ( t , ln ( R ( t ) ) ) (t,\ln(R(t))) ( t , ln ( R ( t ))) R ( t = 0 ) = 1 R(t=0)=1 R ( t = 0 ) = 1 ( t = 0 , ln ( R ( 0 ) ) = 0 ) (t=0,\ln(R(0))=0) ( t = 0 , ln ( R ( 0 )) = 0 )
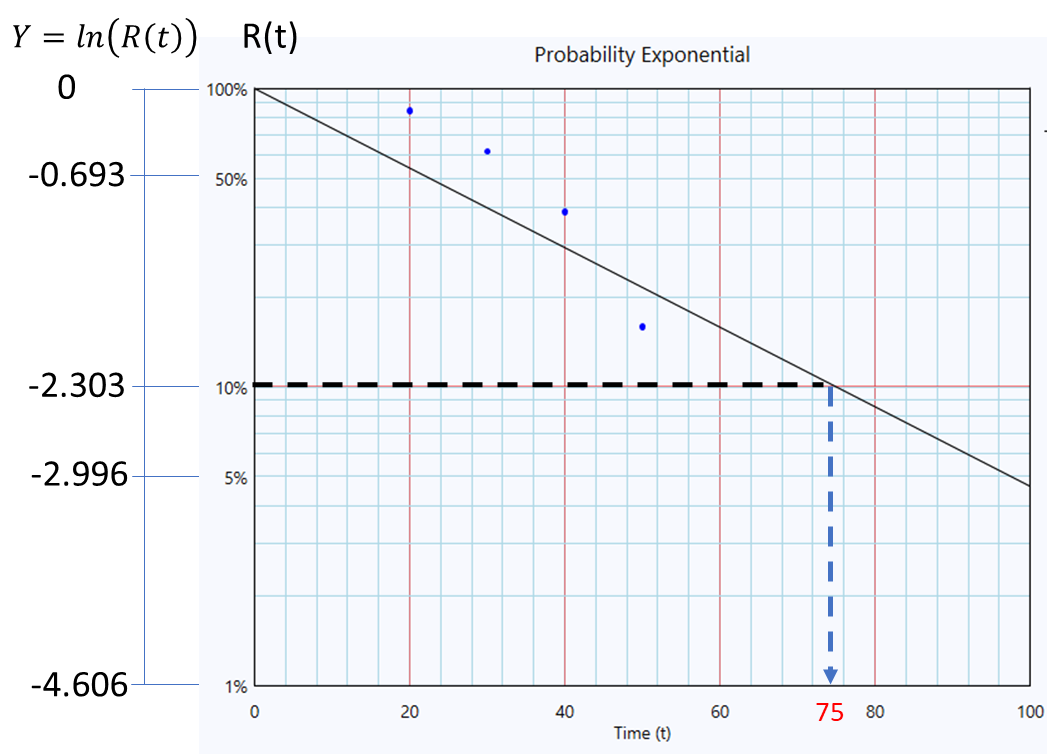
指数概率图 为求斜率,可在拟合线上选取一个已知 Y 值的点。当 Y = − 2.303 Y=-2.303 Y = − 2.303 t = 75 t=75 t = 75
从概率图求取指数分布参数 指数分布参数为:
λ = − 斜率 = − 0 − ( − 2.303 ) 75 = 0.0307 \lambda = -\text{斜率} = - \frac{0 - \left( - \text{2.303~} \right)}{75} = 0.0307 λ = − 斜率 = − 75 0 − ( − 2.303 ) = 0.0307
单位为每单位时间。
威布尔分布 威布尔分布的 CDF 可以写为:
Q ( t ) = 1 − e − ( t η ) β 1 − Q ( t ) = e − ( t η ) β {Q(t) = 1 - e^{- \left( \frac{t}{\eta} \right)^{\beta}}
}{1 - Q(t) = e^{- \left( \frac{t}{\eta} \right)^{\beta}}} Q ( t ) = 1 − e − ( η t ) β 1 − Q ( t ) = e − ( η t ) β ⇒ l n ( ln ( 1 1 − Q ( t ) ) ) = β ∙ l n ( t ) − β ∙ l n ( η ) \Rightarrow \ ln\left( \ln\left( \frac{1}{1 - Q(t)} \right) \right) = \beta \bullet ln(t) - \beta \bullet ln(\eta) ⇒ l n ( ln ( 1 − Q ( t ) 1 ) ) = β ∙ l n ( t ) − β ∙ l n ( η )
将方程线性化为 Y = β X + C Y=\beta X+C Y = βX + C
Y = l n ( ln ( 1 1 − Q ( t ) ) ) Y = ln\left( \ln\left( \frac{1}{1 - Q(t)} \right) \right) Y = l n ( ln ( 1 − Q ( t ) 1 ) )
X = l n ( t ) X = ln(t) X = l n ( t )
斜率 = β \text{斜率} = \beta 斜率 = β
因此,Y 对 X 作图将形成一条斜率为 β \beta β
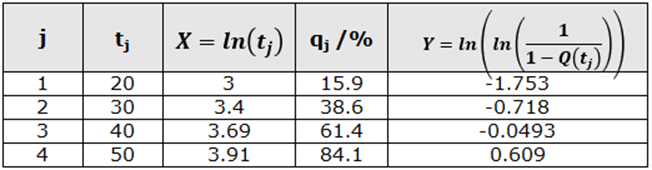
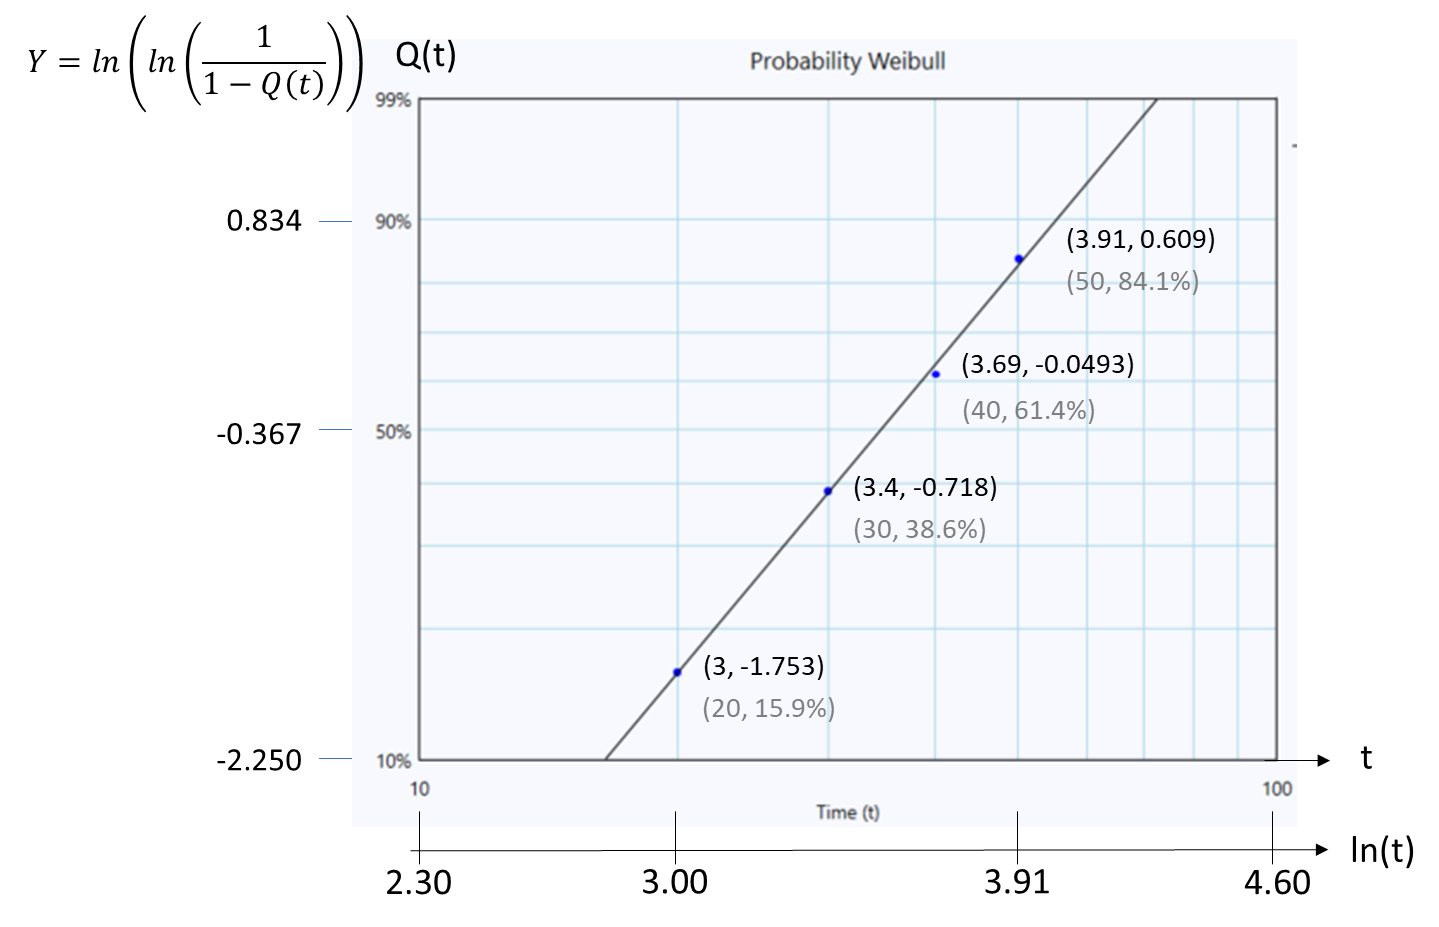
计算各失效时间对应的 X 和 Y 将坐标 ( X , Y ) (X,Y) ( X , Y )
威布尔概率图 由威布尔 CDF:
Q ( t ) = 1 − e − ( t η ) β Q(t) = 1 - e^{- \left( \frac{t}{\eta} \right)^{\beta}} Q ( t ) = 1 − e − ( η t ) β
令 t = η t=\eta t = η
Q ( η ) = 1 − e − ( 1 ) β = 63.1 % Q(\eta) = 1 - e^{- (1)^{\beta}} = 63.1\% Q ( η ) = 1 − e − ( 1 ) β = 63.1%
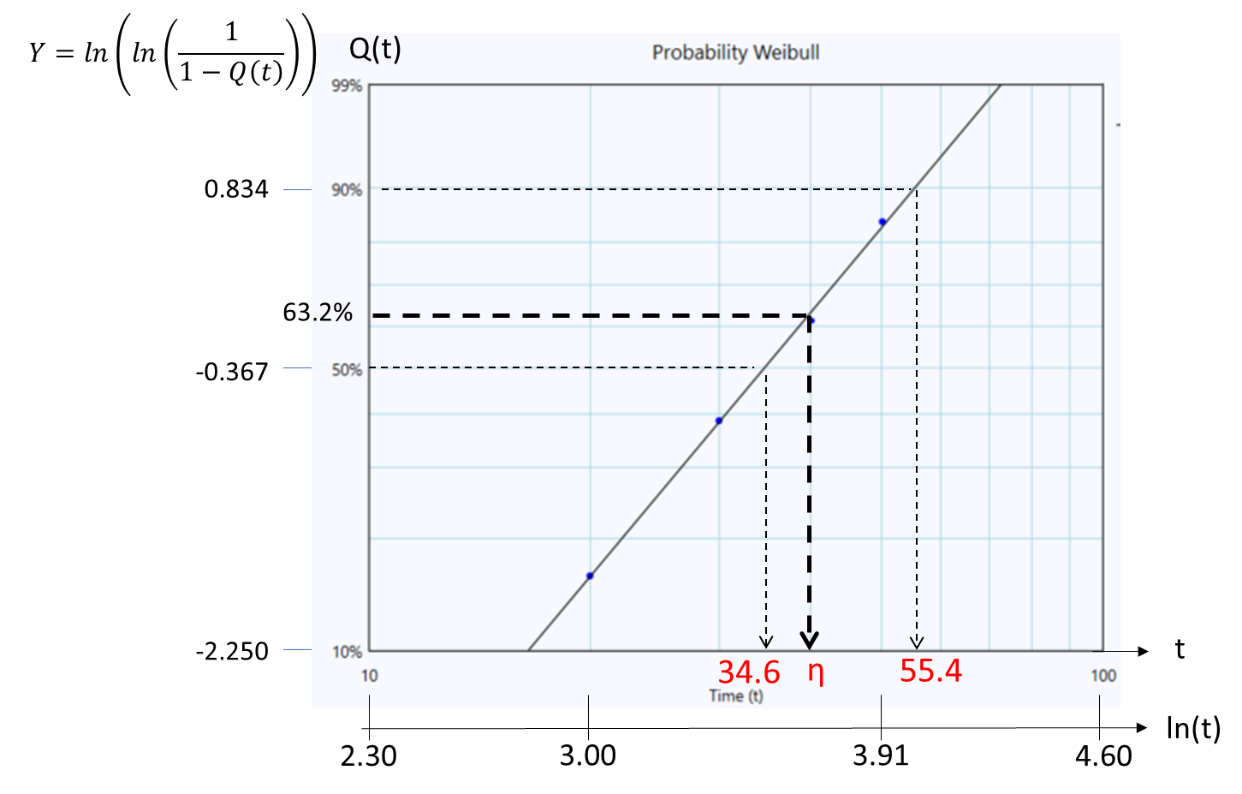
因此,Q = 63.1 % Q=63.1\% Q = 63.1% η \eta η
为求 β \beta β
当 Z = 0.834 Z=0.834 Z = 0.834 Q ( t ) = 0.9 Q(t)=0.9 Q ( t ) = 0.9 当 Z = − 0.367 Z=-0.367 Z = − 0.367 Q ( t ) = 0.5 Q(t)=0.5 Q ( t ) = 0.5
从概率图求取威布尔分布参数 β = 0.834 − ( − 0.367 ) ln ( 55.4 ) − l n ( 34.6 ) = 2.56 \beta = \frac{0.834 - ( - 0.367)}{\ln(55.4) - ln(34.6)} = 2.56 β = l n ( 55.4 ) − l n ( 34.6 ) 0.834 − ( − 0.367 ) = 2.56
正态分布 对于正态分布 N o r ( μ , σ ) Nor(\mu,\sigma) N or ( μ , σ )
Q ( t ) = Φ ( t − μ σ ) Q(t) = \Phi\left( \frac{t - \mu}{\sigma} \right) Q ( t ) = Φ ( σ t − μ )
⇒ Φ − 1 [ Q ( t ) ] = − μ σ + 1 σ t {{\Rightarrow \ \Phi}^{- 1}\left\lbrack Q(t) \right\rbrack = - \frac{\mu}{\sigma} + \frac{1}{\sigma}t} ⇒ Φ − 1 [ Q ( t ) ] = − σ μ + σ 1 t 其中,Φ − 1 \Phi^{-1} Φ − 1 Φ − 1 ( Q ( t ) ) \Phi^{-1}(Q(t)) Φ − 1 ( Q ( t )) t t t − μ / σ -\mu/\sigma − μ / σ 1 / σ 1/\sigma 1/ σ
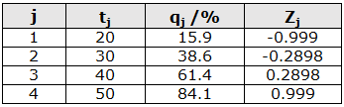
将累积概率 Q ( t ) Q(t) Q ( t )
Z = Φ − 1 ( Q ( t ) ) Z = \Phi^{- 1}\left( Q(t) \right) Z = Φ − 1 ( Q ( t ) )
可以使用标准正态表或 Excel 函数 NORM.S.INV(Q) 得到 Z 值。
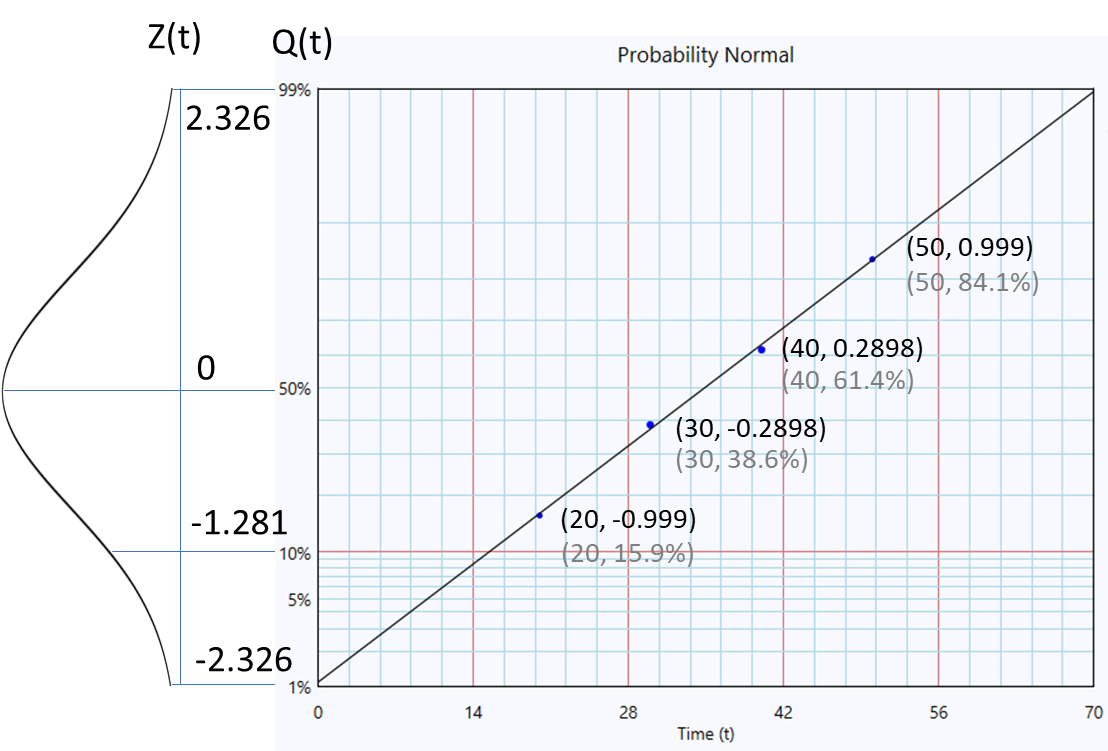
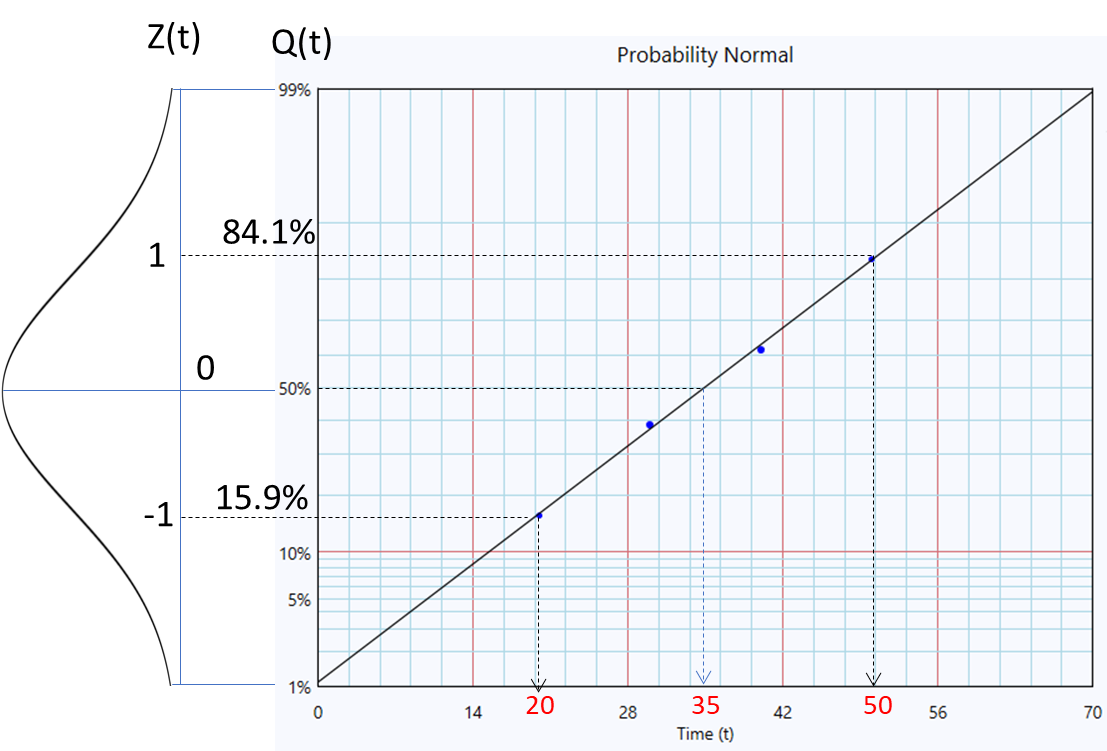
计算各 Q(t) 对应的标准正态分位数 将坐标 ( t , Z ) (t,Z) ( t , Z )
正态概率图 数学上可由 Y 轴截距 − μ / σ -\mu/\sigma − μ / σ 1 / σ 1/\sigma 1/ σ Q ( t = μ ) = 50 % Q(t=\mu)=50\% Q ( t = μ ) = 50% μ = 35 \mu=35 μ = 35
为求 σ \sigma σ Z = 1 Z=1 Z = 1 Z = − 1 Z=-1 Z = − 1
当 Z = 1 Z=1 Z = 1 Q ( t ) = 0.841 Q(t)=0.841 Q ( t ) = 0.841 当 Z = − 1 Z=-1 Z = − 1 Q ( t ) = 0.159 Q(t)=0.159 Q ( t ) = 0.159 可以使用标准正态表或 Excel 函数 NORM.S.DIST(Z) 得到累积概率。
从概率图求取正态分布参数 标准差为:
σ = 1 斜率 = 50 − 30 1 − ( − 1 ) = 15 {\sigma = \frac{1}{\text{斜率}}
}{= \frac{50 - 30}{1 - ( - 1)} = 15} σ = 斜率 1 = 1 − ( − 1 ) 50 − 30 = 15 对数正态分布 若变量 t t t ln ( t ) \ln(t) ln ( t )
对数正态分布 L o g ( μ ′ , σ ′ ) Log(\mu',\sigma') L o g ( μ ′ , σ ′ )
Q ( t ) = Φ ( ln ( t ) − μ ′ σ ′ ) Q(t) = \Phi\left( \frac{\ln(t) - \mu'}{\sigma'} \right) Q ( t ) = Φ ( σ ′ l n ( t ) − μ ′ )
⇒ Φ − 1 [ Q ( t ) ] = − μ ′ σ ′ + 1 σ ′ ln ( t ) \Rightarrow \ \Phi^{- 1}\left\lbrack Q(t) \right\rbrack = - \frac{\mu'}{\sigma'} + \frac{1}{\sigma'}\ln(t) ⇒ Φ − 1 [ Q ( t ) ] = − σ ′ μ ′ + σ ′ 1 ln ( t )
其中:
μ ′ \mu' μ ′ σ ′ \sigma' σ ′ 若以 Φ − 1 ( Q ( t ) ) \Phi^{-1}(Q(t)) Φ − 1 ( Q ( t )) ln ( t ) \ln(t) ln ( t ) 1 / σ ′ 1/\sigma' 1/ σ ′
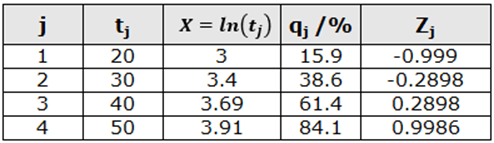
将 Y 轴的累积概率转换为标准正态分位数:
Z = Φ − 1 ( Q ( t ) ) Z=\Phi^{-1}(Q(t)) Z = Φ − 1 ( Q ( t ))
同时将 X 轴转换为 ln ( t ) \ln(t) ln ( t ) NORM.S.INV(Q) 求取 Z 值。
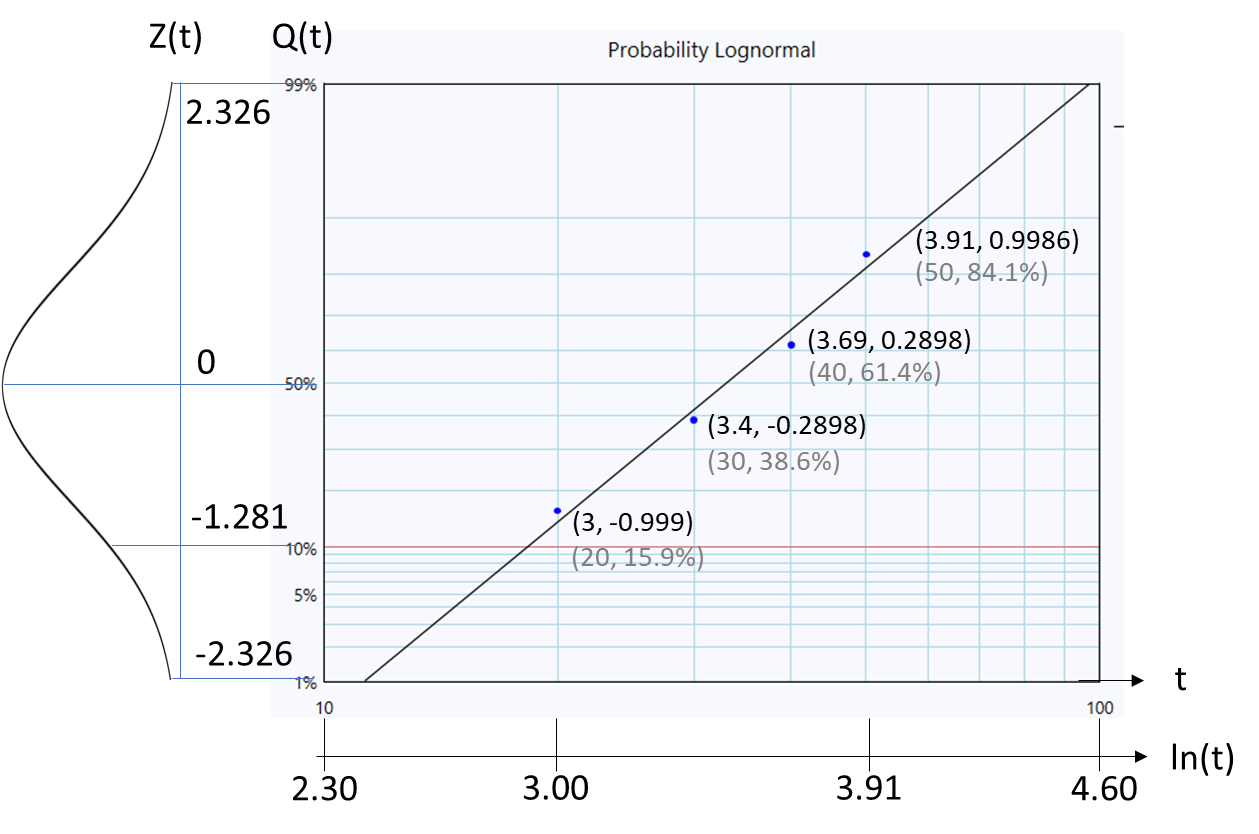
将 X 轴转换为 ln(t),Y 轴转换为标准正态分位数 将坐标 ( ln ( t ) , Z ) (\ln(t),Z) ( ln ( t ) , Z )
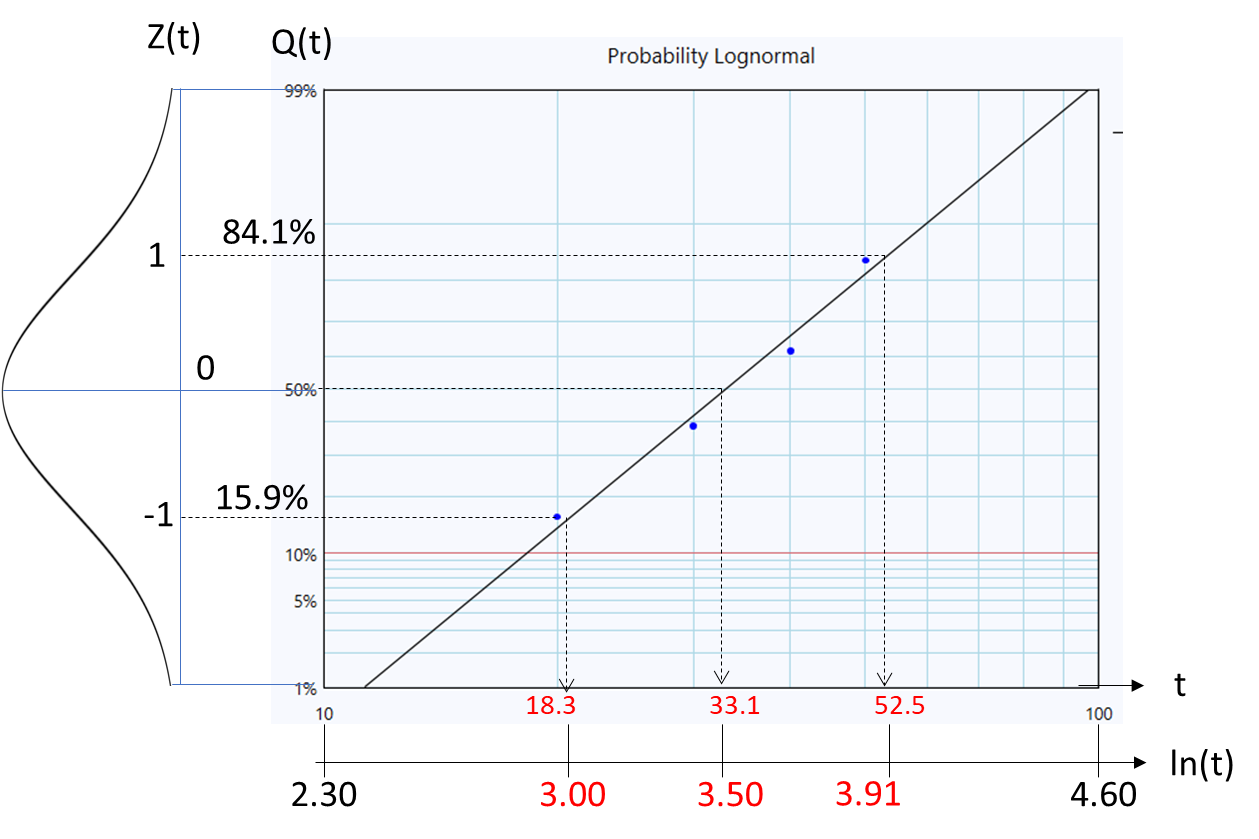
对数正态概率图 对数均值 μ ′ \mu' μ ′ Z = 0 Z=0 Z = 0 Q ( t ) = 50 % Q(t)=50\% Q ( t ) = 50% ln ( t ) = μ ′ \ln(t)=\mu' ln ( t ) = μ ′ Q ( t ) = 50 % Q(t)=50\% Q ( t ) = 50% t = 33.1 t=33.1 t = 33.1
μ ′ = ln ( 33.1 ) = 3.5 \mu'=\ln(33.1)=3.5 μ ′ = ln ( 33.1 ) = 3.5
为求 σ ′ \sigma' σ ′ Z = 1 Z=1 Z = 1 Z = − 1 Z=-1 Z = − 1 t t t
从概率图求取对数正态分布参数 对数标准差为:
σ ′ = 1 斜率 = ln ( 52.5 ) − l n ( 18.3 ) 1 − ( − 1 ) = 3.91 − 3 2 = 0.46 {\sigma' = \frac{1}{\text{斜率}}
}{= \frac{\ln(52.5) - ln(18.3)}{1 - ( - 1)}
}{= \frac{3.91 - 3}{2} = 0.46} σ ′ = 斜率 1 = 1 − ( − 1 ) ln ( 52.5 ) − l n ( 18.3 ) = 2 3.91 − 3 = 0.46 秩回归 秩回归通过对观测数据拟合直线来估计分布参数,其目标是使观测值与拟合直线预测值之间的平方误差之和最小。
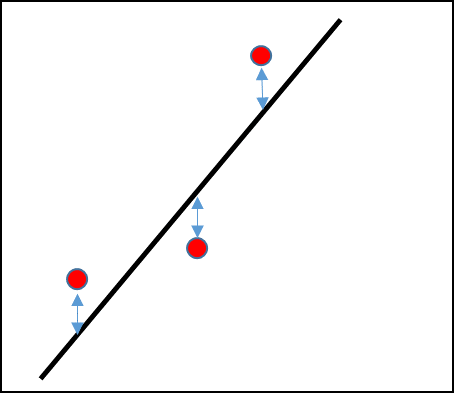
Y 方向秩回归 RRY(Rank Regression on Y)拟合线使各数据点与回归线之间 Y 方向的误差最小。当需要根据给定概率预测时间(例如在不可靠度为 90% 时预测失效时间)时,通常使用 RRY。
Y 方向秩回归 给定成对数据点 ( x 1 , y 1 ) , ( x 2 , y 2 ) , … , ( x n , y n ) (x_1,y_1),(x_2,y_2),\ldots,(x_n,y_n) ( x 1 , y 1 ) , ( x 2 , y 2 ) , … , ( x n , y n )
y i = a ′ + b ′ x i + e i y_{i} = a' + b'x_{i} + e_{i} y i = a ′ + b ′ x i + e i
其中:
b ′ = ∑ i = 1 n ( y i − y ‾ ) ( x i − x ‾ ) ∑ i = 1 n ( x i − x ‾ ) 2 b' = \frac{\sum_{i = 1}^{n}{\left( y_{i} - \overline{y} \right)\left( x_{i} - \overline{x} \right)}}{\sum_{i = 1}^{n}\left( x_{i} - \overline{x} \right)^{2}} b ′ = ∑ i = 1 n ( x i − x ) 2 ∑ i = 1 n ( y i − y ) ( x i − x )
a ′ = y ‾ − b ′ x ‾ a' = \overline{y} - b^{'\overline{x}} a ′ = y − b ′ x
x ‾ = 1 n ∑ i = 1 n x i \overline{x} = \frac{1}{n}\sum_{i = 1}^{n}x_{i} x = n 1 ∑ i = 1 n x i
y ‾ = 1 n ∑ i = 1 n y i \overline{y} = \frac{1}{n}\sum_{i = 1}^{n}y_{i} y = n 1 ∑ i = 1 n y i
e i e_i e i
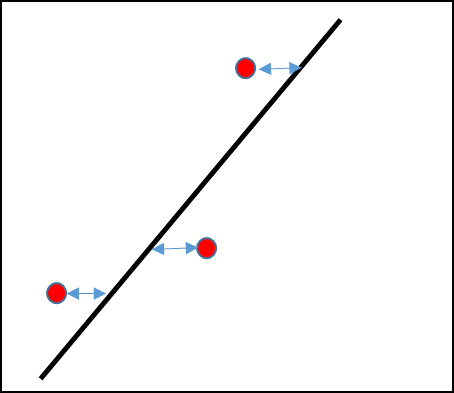
X 方向秩回归 RRX(Rank Regression on X)拟合线使各数据点与回归线之间 X 方向的误差最小。当需要根据给定时间预测概率时,通常使用 RRX。
X 方向秩回归 给定成对数据点,并假定 Y 值准确已知,为使 X 方向误差最小,对 X 关于 Y 进行回归:
x i = a ′ + b ′ y i + e i x_{i} = a' + b'y_{i} + e_{i} x i = a ′ + b ′ y i + e i
其中:
b ′ = ∑ i = 1 n ( y i − y ‾ ) ( x i − x ‾ ) ∑ i = 1 n ( y i − y ‾ ) 2 b' = \frac{\sum_{i = 1}^{n}{\left( y_{i} - \overline{y} \right)\left( x_{i} - \overline{x} \right)}}{\sum_{i = 1}^{n}\left( y_{i} - \overline{y} \right)^{2}} b ′ = ∑ i = 1 n ( y i − y ) 2 ∑ i = 1 n ( y i − y ) ( x i − x )
a ′ = x ‾ − b ′ y ‾ a' = \overline{x} - b'\overline{y} a ′ = x − b ′ y
x ‾ = 1 n ∑ i = 1 n x i \overline{x} = \frac{1}{n}\sum_{i = 1}^{n}x_{i} x = n 1 ∑ i = 1 n x i
y ‾ = 1 n ∑ i = 1 n y i \overline{y} = \frac{1}{n}\sum_{i = 1}^{n}y_{i} y = n 1 ∑ i = 1 n y i
e i e_i e i
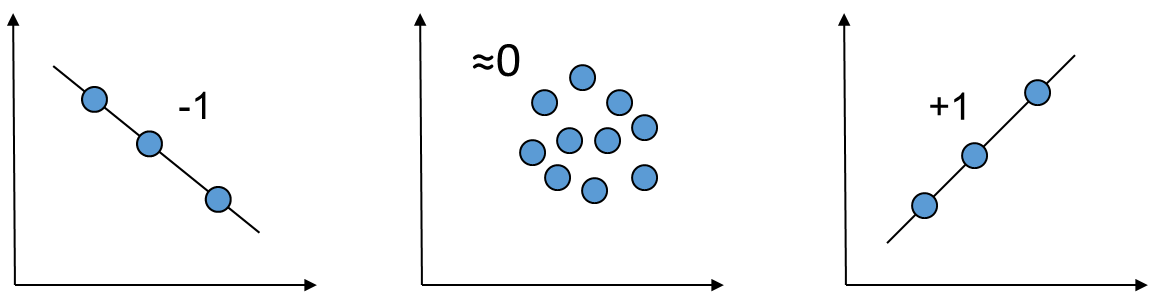
相关系数 秩回归中的一个重要概念是相关系数,用来衡量所选分布对数据的拟合程度。相关系数 ρ \rho ρ
ρ = C o v ( X , Y ) σ X σ Y = ∑ i = 1 n ( x i − x ‾ ) ( y i − y ‾ ) ∑ i = 1 n ( x i − x ‾ ) 2 ∑ i = 1 n ( y i − y ‾ ) 2 {\rho = \frac{Cov(X,Y)}{\sigma_{X}\sigma_{Y}}
}{= \frac{\sum_{i = 1}^{n}\left( x_{i} - \overline{x} \right)\left( y_{i} - \overline{y} \right)}{\sqrt{\sum_{i = 1}^{n}\left( x_{i} - \overline{x} \right)^{2}\sum_{i = 1}^{n}\left( y_{i} - \overline{y} \right)^{2}}}} ρ = σ X σ Y C o v ( X , Y ) = ∑ i = 1 n ( x i − x ) 2 ∑ i = 1 n ( y i − y ) 2 ∑ i = 1 n ( x i − x ) ( y i − y ) 其中:
x ‾ \overline{x} x y ‾ \overline{y} y C o v ( X , Y ) Cov(X,Y) C o v ( X , Y ) σ X \sigma_X σ X σ Y \sigma_Y σ Y 解释如下:
数值范围为 -1 至 +1。 -1 表示负斜率的完全拟合。 +1 表示正斜率的完全拟合。
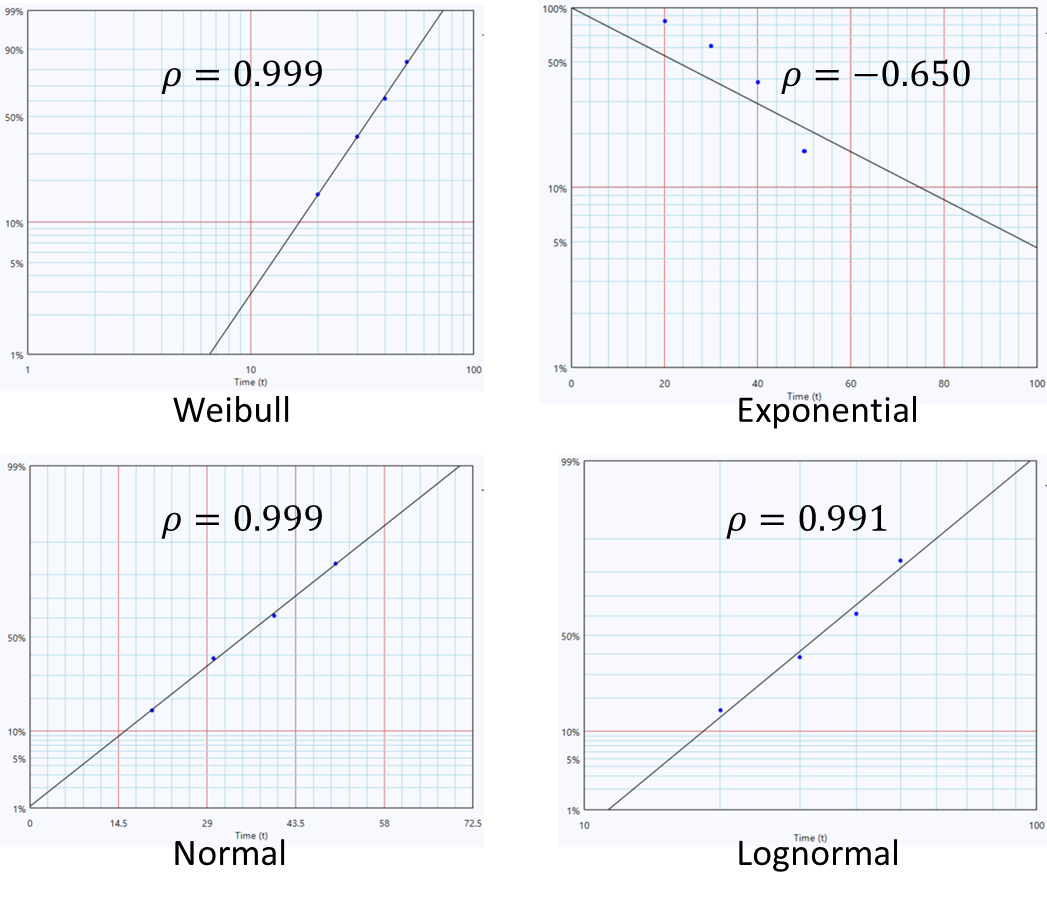
相关系数衡量数据点形成直线的程度 考虑数据集 {20, 30, 40, 50}。下图显示使用 RRX 将该数据拟合至指数、威布尔、正态和对数正态模型时得到的 ρ \rho ρ
不同分布的相关系数 在概率图法(秩回归)中,ρ \rho ρ
极大似然估计(Maximum Likelihood Estimation,MLE)是一种估计概率分布参数的统计方法。它寻找一组参数,使在假定分布下观察到当前数据的可能性最大。其核心是建立一个似然函数,将观测数据的概率或概率密度表示为未知参数的函数,再求使该函数达到最大值的参数。
令:
f ( t ; θ ) f(t;\theta) f ( t ; θ ) F ( t ; θ ) F(t;\theta) F ( t ; θ ) R ( t ; θ ) = 1 − F ( t ; θ ) R(t;\theta)=1-F(t;\theta) R ( t ; θ ) = 1 − F ( t ; θ ) θ \theta θ n 1 n_1 n 1 t i t_i t i n 2 n_2 n 2 t i t_i t i n 3 n_3 n 3 t L i t_{L_i} t L i t U i t_{U_i} t U i 完整似然函数为:
L ( θ ) = ∏ i = 1 n 1 f ( t i ; θ ) × ∏ i = 1 n 2 R ( t i ; θ ) × ∏ i = 1 n 3 [ F ( t U i ; θ ) − F ( t L i ; θ ) ] L(\theta) = \prod_{i = 1}^{n_{1}}{f\left( t_{i};\theta \right) \times \text{~}}\prod_{i = 1}^{n_{2}}{R\left( t_{i};\theta \right) \times \prod_{i = 1}^{n_{3}}{\left\lbrack F\left( t_{U_{i}};\theta \right) - F\left( t_{L_{i}};\theta \right) \right\rbrack\text{~}}} L ( θ ) = ∏ i = 1 n 1 f ( t i ; θ ) × ∏ i = 1 n 2 R ( t i ; θ ) × ∏ i = 1 n 3 [ F ( t U i ; θ ) − F ( t L i ; θ ) ]
直接求乘积的最大值较为复杂,因此通常使用对数似然函数 :
Λ = l n ( L ( θ ) ) = ∑ i = 1 n 1 ln ( f ( t i ; θ ) ) × ∑ i = 1 n 2 ln ( R ( t i ; θ ) ) × ∑ i = 1 n 3 ln [ F ( t U i ; θ ) − F ( t L i ; θ ) ] \Lambda = ln\left( L(\theta) \right) = \sum_{i = 1}^{n_{1}}{\ln\left( f\left( t_{i};\theta \right) \right) \times \sum_{i = 1}^{n_{2}}{\ln\left( R\left( t_{i};\theta \right) \right) \times \sum_{i = 1}^{n_{3}}{\ln\left\lbrack F\left( t_{U_{i}};\theta \right) - F\left( t_{L_{i}};\theta \right) \right\rbrack\text{~}}}} Λ = l n ( L ( θ ) ) = ∑ i = 1 n 1 ln ( f ( t i ; θ ) ) × ∑ i = 1 n 2 ln ( R ( t i ; θ ) ) × ∑ i = 1 n 3 ln [ F ( t U i ; θ ) − F ( t L i ; θ ) ]
MLE 寻找使对数似然 Λ \Lambda Λ θ \theta θ
以下示例将一个数据集采用 MLE 拟合至威布尔分布。
威布尔分布函数 PDF:
f ( t ; β , η ) = β η ( t η ) β − 1 e − ( t η ) β f(t;\beta,\eta) = \frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1}e^{{- \left( \frac{t}{\eta} \right)}^{\beta}} f ( t ; β , η ) = η β ( η t ) β − 1 e − ( η t ) β
CDF:
Q ( t ; β , η ) = 1 − e − ( t η ) β Q(t;\beta,\eta) = 1 - e^{- \left( \frac{t}{\eta} \right)^{\beta}} Q ( t ; β , η ) = 1 − e − ( η t ) β
可靠度:
R ( t ; β , η ) = e − ( t η ) β R(t;\beta,\eta) = e^{- \left( \frac{t}{\eta} \right)^{\beta}} R ( t ; β , η ) = e − ( η t ) β
对数似然函数:
Λ = l n ( f ( 20 ; β , η ) ) + l n ( f ( 30 ; β , η ) ) + 2 × l n ( R ( 40 ; β , η ) ) + l n [ F ( 30 ; β , η ) − F ( 50 ; β , η ) ] \small\Lambda = ln\left( f(20;\beta,\eta) \right) + ln\left( f(30;\beta,\eta) \right) + 2 \times ln\left( R(40;\beta,\eta) \right) + ln\left\lbrack F(30;\beta,\eta) - F(50;\beta,\eta) \right\rbrack Λ = l n ( f ( 20 ; β , η ) ) + l n ( f ( 30 ; β , η ) ) + 2 × l n ( R ( 40 ; β , η ) ) + l n [ F ( 30 ; β , η ) − F ( 50 ; β , η ) ]
代入威布尔分布函数:
Λ = [ ln ( β η ) + ( β − 1 ) ln ( 20 ) − ( 20 η ) β ] + [ ln ( β η ) + ( β − 1 ) ln ( 30 ) − ( 30 η ) β ] \small\Lambda = \left\lbrack \ln\left( \frac{\beta}{\eta} \right) + (\beta - 1)\ln(20) - \left( \frac{20}{\eta} \right)^{\beta} \right\rbrack + \left\lbrack \ln\left( \frac{\beta}{\eta} \right) + (\beta - 1)\ln(30) - \left( \frac{30}{\eta} \right)^{\beta} \right\rbrack Λ = [ ln ( η β ) + ( β − 1 ) ln ( 20 ) − ( η 20 ) β ] + [ ln ( η β ) + ( β − 1 ) ln ( 30 ) − ( η 30 ) β ]
− 2 ( 40 η ) β + l n ( e − ( 30 η ) β − e − ( 50 η ) β ) \small- 2\left( \frac{40}{\eta} \right)^{\beta} + ln\left( e^{- \left( \frac{30}{\eta} \right)^{\beta}} - e^{- \left( \frac{50}{\eta} \right)^{\beta}} \right) − 2 ( η 40 ) β + l n ( e − ( η 30 ) β − e − ( η 50 ) β )
上述对数似然是 β \beta β η \eta η Λ \Lambda Λ β \beta β η \eta η
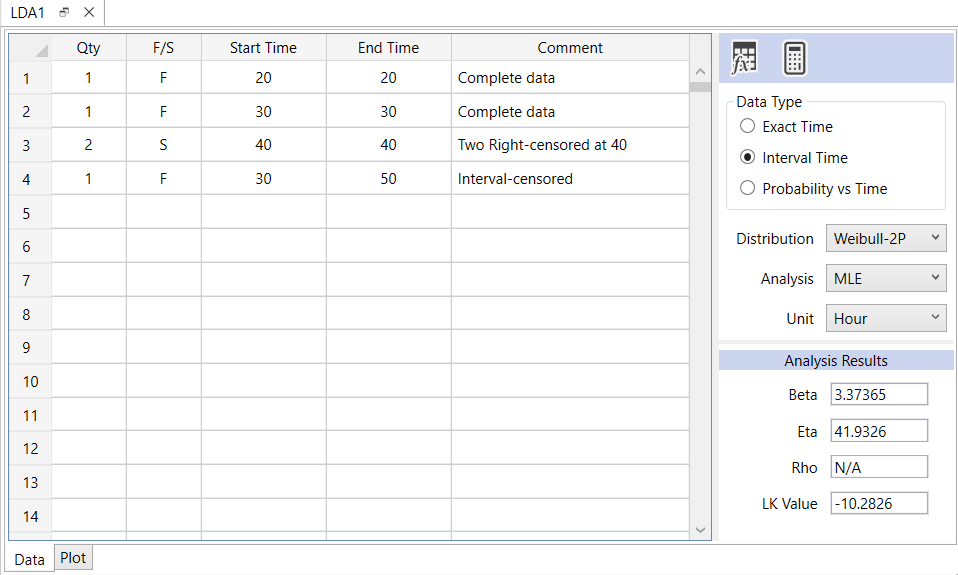
将威布尔分布拟合至示例数据 本例得到 β = 3.37 \beta=3.37 β = 3.37 η = 41.9 \eta=41.9 η = 41.9
Λ = [ ln ( 3.37 41.9 ) + ( 3.37 − 1 ) ln ( 20 ) − ( 20 41.9 ) 3.37 ] + [ ln ( 3.37 41.9 ) + ( 3.37 − 1 ) ln ( 30 ) − ( 30 41.9 ) 3.37 ] \small\Lambda = \left\lbrack \ln\left( \frac{\text{3.37}}{\text{41.9}} \right) + \left( \text{3.37} - 1 \right)\ln(20) - \left( \frac{20}{\text{41.9}} \right)^{\text{3.37}} \right\rbrack + \left\lbrack \ln\left( \frac{\text{3.37}}{\text{41.9}} \right) + \left( \text{3.37} - 1 \right)\ln(30) - \left( \frac{30}{\text{41.9}} \right)^{\text{3.37}} \right\rbrack Λ = [ ln ( 41.9 3.37 ) + ( 3.37 − 1 ) ln ( 20 ) − ( 41.9 20 ) 3.37 ] + [ ln ( 41.9 3.37 ) + ( 3.37 − 1 ) ln ( 30 ) − ( 41.9 30 ) 3.37 ]
− 2 ( 40 41.9 ) 3.37 + l n ( e − ( 30 41.9 ) 3.37 − e − ( 50 41.9 ) 3.37 ) = − 10.28 \small - 2\left( \frac{40}{\text{41.9}} \right)^{\text{3.37}}+ ln\left( e^{- \left( \frac{30}{\text{41.9}} \right)^{\text{3.37}}} - e^{- \left( \frac{50}{\text{41.9}} \right)^{\text{3.37}}} \right)
{= - 10.28} − 2 ( 41.9 40 ) 3.37 + l n ( e − ( 41.9 30 ) 3.37 − e − ( 41.9 50 ) 3.37 ) = − 10.28 在 Weibull Toolbox 中,对数似然值以 LK Value 显示在分析结果中。
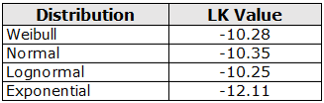
若将同一数据集分别拟合至正态、对数正态、威布尔和指数分布,可比较它们的 LK Value:
不同分布的 LK Value 正态分布得到最高(即最接近零)的 LK Value,因此在这些候选分布中拟合最佳。指数分布的 LK Value 明显较低,表示其对数据的拟合较差。
方法选择。 没有一种置信限方法在所有情况下都必然优于其他方法。Fisher 矩阵法、似然比法和模拟法采用不同的近似方法,特别是在数据量有限或存在大量删失数据时,可能得到不同的结果。所选方法应与数据、拟合模型以及需要解决的工程问题相适应。
将威布尔模型拟合至失效数据后,可以利用 Fisher 矩阵置信限(FMCB)量化参数估计值 β ^ \widehat{\beta} β η ^ \widehat{\eta} η β \beta β η \eta η
参数的 Fisher 矩阵置信限 以下使用威布尔分布说明 Fisher 矩阵置信限;相同概念也适用于其他寿命分布模型。
二参数威布尔分布的似然函数为:
L ( β , η ) = ∏ i = 1 n [ ( β η ( t i η ) β − 1 ) δ i ⋅ e x p ( − ( t i η ) β ) ] L(\beta,\eta) = \prod_{i = 1}^{n}\left\lbrack \left( \frac{\beta}{\eta}\left( \frac{t_{i}}{\eta} \right)^{\beta - 1} \right)^{\delta_{i}} \cdot exp\left( - \left( \frac{t_{i}}{\eta} \right)^{\beta} \right) \right\rbrack L ( β , η ) = ∏ i = 1 n [ ( η β ( η t i ) β − 1 ) δ i ⋅ e x p ( − ( η t i ) β ) ]
其中,t i t_i t i i i i δ i = 1 \delta_i=1 δ i = 1 δ i = 0 \delta_i=0 δ i = 0
对数似然函数为:
ln ( L ( β , η ) ) = ∑ i = 1 n δ i [ ln ( β ) − β l n ( η ) + ( β − 1 ) ln ( t i ) ] − ∑ i = 1 n ( t i η ) β \ln\left( L(\beta,\eta) \right) = \sum_{i = 1}^{n}\delta_{i}\left\lbrack \ln(\beta) - \beta ln(\eta) + (\beta - 1)\ln\left( t_{i} \right) \right\rbrack - \sum_{i = 1}^{n}\left( \frac{t_{i}}{\eta} \right)^{\beta} ln ( L ( β , η ) ) = ∑ i = 1 n δ i [ ln ( β ) − βl n ( η ) + ( β − 1 ) ln ( t i ) ] − ∑ i = 1 n ( η t i ) β
威布尔分布的 Fisher 信息矩阵
Fisher 信息矩阵 I ( β , η ) I(\beta,\eta) I ( β , η )
I ( β , η ) = [ − ∂ 2 ln L ∂ β 2 − ∂ 2 ln L ∂ β ∂ η − ∂ 2 ln L ∂ β ∂ η − ∂ 2 ln L ∂ η 2 ] ∣ ( β ^ , η ^ ) I(\beta, \eta) = \left. \begin{bmatrix}
-\frac{\partial^2 \ln L}{\partial \beta^2} & -\frac{\partial^2 \ln L}{\partial \beta \partial \eta} \\
-\frac{\partial^2 \ln L}{\partial \beta \partial \eta} & -\frac{\partial^2 \ln L}{\partial \eta^2}
\end{bmatrix} \right|_{(\hat{\beta}, \hat{\eta})} I ( β , η ) = [ − ∂ β 2 ∂ 2 l n L − ∂ β ∂ η ∂ 2 l n L − ∂ β ∂ η ∂ 2 l n L − ∂ η 2 ∂ 2 l n L ] ( β ^ , η ^ ) 其逆矩阵给出估计值的协方差矩阵:
C o v ( β ^ , η ^ ) ≈ I − 1 ( β ^ , η ^ ) = [ V a r ( β ^ ) C o v ( β ^ , η ^ ) C o v ( β ^ , η ^ ) V a r ( η ^ ) ] Cov\left( \widehat{\beta},\widehat{\eta} \right) \approx I^{- 1}\left( \widehat{\beta},\widehat{\eta} \right) = \begin{bmatrix}
Var\left( \widehat{\beta} \right) & Cov\left( \widehat{\beta},\widehat{\eta} \right) \\
Cov\left( \widehat{\beta},\widehat{\eta} \right) & Var\left( \widehat{\eta} \right)
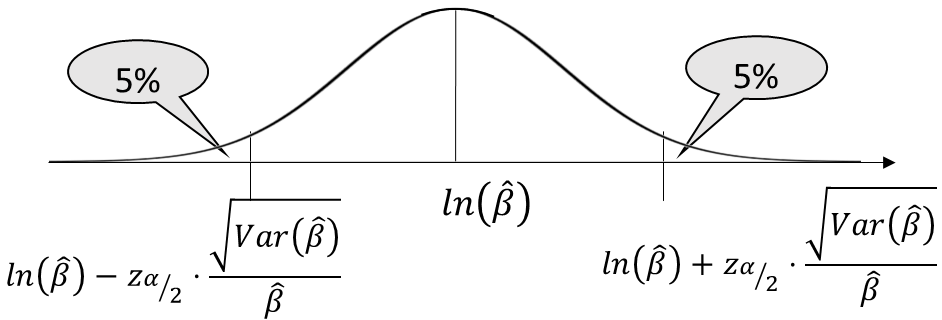
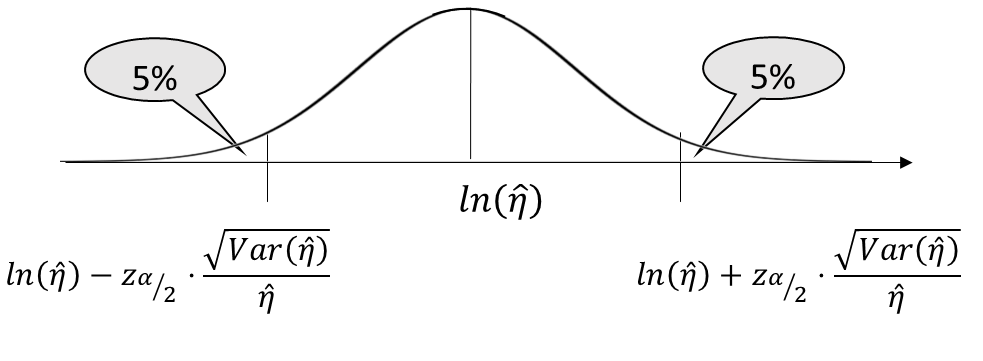
\end{bmatrix} C o v ( β , η ) ≈ I − 1 ( β , η ) = Va r ( β ) C o v ( β , η ) C o v ( β , η ) Va r ( η ) 假设 ln ( β ) \ln(\beta) ln ( β ) ln ( η ) \ln(\eta) ln ( η ) β \beta β η \eta η
形状参数 β \beta β
ln ( β U , L ) = l n ( β ^ ) ± z α 2 ⋅ V a r ( ln ( β ^ ) ) \ln\left( \beta_{U,L} \right) = ln\left( \widehat{\beta} \right) \pm z_{\frac{\alpha}{2}} \cdot \sqrt{Var\left( \ln\left( \widehat{\beta} \right) \right)} ln ( β U , L ) = l n ( β ) ± z 2 α ⋅ Va r ( ln ( β ) )
利用 Delta 方法:
V a r ( l n ( β ^ ) ≈ V a r ( β ^ ) β 2 Var(ln(\widehat{\beta}) \approx \frac{Var(\widehat{\beta})}{\beta^{2}} Va r ( l n ( β ) ≈ β 2 Va r ( β )
因此:
ln ( β U , L ) = ln ( β ^ ) ± z α 2 ⋅ V a r ( β ^ ) β ^ \ln\left( \beta_{U,L} \right) = \ln\left( \widehat{\beta} \right) \pm z_{\frac{\alpha}{2}} \cdot \frac{\sqrt{Var\left( \widehat{\beta} \right)}}{\widehat{\beta}} ln ( β U , L ) = ln ( β ) ± z 2 α ⋅ β Va r ( β )
对于 90% 置信水平,α = 0.1 \alpha=0.1 α = 0.1 z α / 2 = 1.64 z_{\alpha/2}=1.64 z α /2 = 1.64
ln(beta) 的 90% Fisher 矩阵置信限 置信水平 α \alpha α β \beta β
β U , L = β ^ ∙ e ± z α 2 V a r ( β ^ ) β ^ \beta_{U,L} = \widehat{\beta} \bullet e^{\pm z_{\frac{\alpha}{2}}\frac{\sqrt{Var\left( \widehat{\beta} \right)}}{\widehat{\beta}}} β U , L = β ∙ e ± z 2 α β Va r ( β )
尺度参数 η \eta η
ln ( η U , L ) = l n ( η ^ ) ± z α 2 ⋅ V a r ( η ^ ) η ^ \ln\left( \eta_{U,L} \right) = ln\left( \widehat{\eta} \right) \pm z_{\frac{\alpha}{2}} \cdot \frac{\sqrt{Var\left( \widehat{\eta} \right)}}{\widehat{\eta}} ln ( η U , L ) = l n ( η ) ± z 2 α ⋅ η Va r ( η )
ln(eta) 的 90% Fisher 矩阵置信限 η U , L = η ^ ∙ e ± z α 2 V a r ( η ^ ) η ^ \eta_{U,L} = \widehat{\eta} \bullet e^{\pm z_{\frac{\alpha}{2}}\frac{\sqrt{Var\left( \widehat{\eta} \right)}}{\widehat{\eta}}} η U , L = η ∙ e ± z 2 α η Va r ( η )
示例
将数据集 {20, 30, 40, 50} 使用 RRX 拟合至二参数威布尔分布,求参数的 90% 置信限。
RRX 解为:β = 2.55 \beta=2.55 β = 2.55 η = 39.9 \eta=39.9 η = 39.9
Fisher 信息矩阵:
I ( β , η ) = [ 0.827 0.00486 0.00486 0.0131 ] I(\beta, \eta) =
\begin{bmatrix}
0.827 & 0.00486 \\
0.00486 & 0.0131
\end{bmatrix} I ( β , η ) = [ 0.827 0.00486 0.00486 0.0131 ] 协方差矩阵:
C o v ( β ^ , η ^ ) = [ 1.215 − 0.4493 − 0.4493 76.42 ] Cov\left( \widehat{\beta},\widehat{\eta} \right)
=
\begin{bmatrix}
1.215 & -0.4493 \\
-0.4493 & 76.42
\end{bmatrix} C o v ( β , η ) = [ 1.215 − 0.4493 − 0.4493 76.42 ] 因此:
V a r ( β ^ ) = 1.215 Var\left( \widehat{\beta} \right)=1.215 Va r ( β ) = 1.215
V a r ( η ^ ) = 76.42 Var\left( \widehat{\eta} \right)=76.42 Va r ( η ) = 76.42
β U = β ^ ∙ e z α 2 V a r ( β ^ ) β ^ \beta_{U} = \widehat{\beta} \bullet e^{z_{\frac{\alpha}{2}}\frac{\sqrt{Var\left( \widehat{\beta} \right)}}{\widehat{\beta}}} β U = β ∙ e z 2 α β Va r ( β )
β L = β ^ ∙ e − z α 2 V a r ( β ^ ) β ^ \beta_{L} = \widehat{\beta} \bullet e^{- z_{\frac{\alpha}{2}}\frac{\sqrt{Var\left( \widehat{\beta} \right)}}{\widehat{\beta}}} β L = β ∙ e − z 2 α β Va r ( β )
η U = 39.9 × e 1.64 ( 76.42 39.9 ) = 57.23 \eta_{U} = 39.9 \times e^{1.64\left( \frac{\sqrt{76.42}}{39.9} \right)} = 57.23 η U = 39.9 × e 1.64 ( 39.9 76.42 ) = 57.23
η L = 39.9 × e − 1.64 ( 76.42 39.9 ) = 27.84 \eta_{L} = 39.9 \times e^{-1.64\left( \frac{\sqrt{76.42}}{39.9} \right)} = 27.84 η L = 39.9 × e − 1.64 ( 39.9 76.42 ) = 27.84
Fisher 矩阵置信限的概念可概括为:
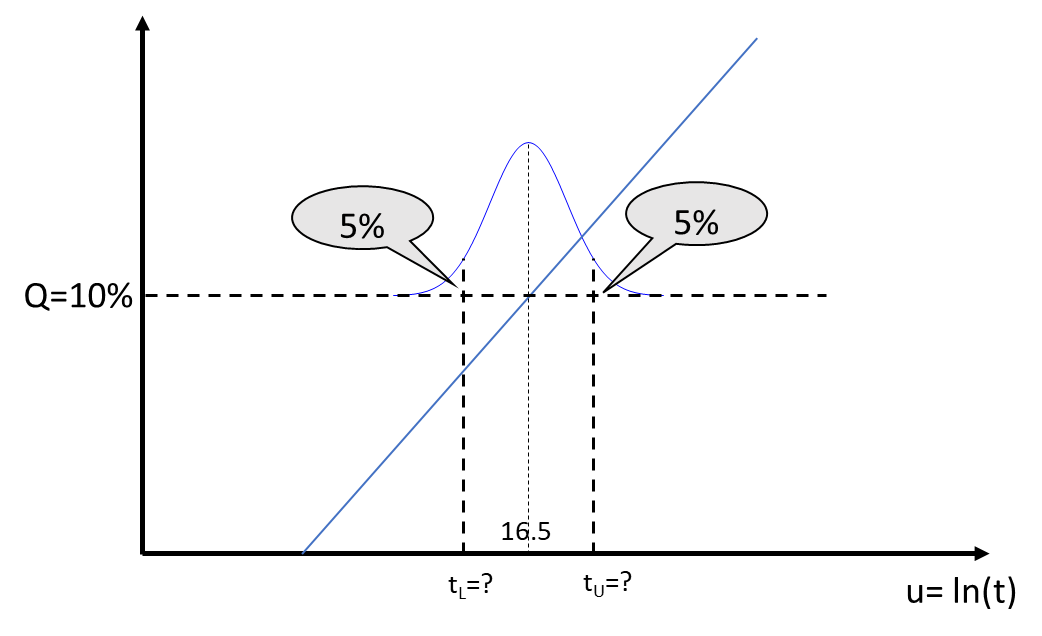
通过统计分析(本例为 MLE 或 RRX)得到估计值,作为均值。 由 Fisher 信息矩阵求得标准差。 使用由标准正态分位数定义置信水平的正态分布,对估计值建立置信限。 时间的 Fisher 矩阵置信限 将数据集 {20, 30, 40, 50} 拟合至二参数威布尔分布,求总体中 10% 失效(不可靠度 Q = 10 % Q=10\% Q = 10%
RRX 解为:β = 2.55 \beta=2.55 β = 2.55 η = 39.9 \eta=39.9 η = 39.9
威布尔 CDF:
Q ( t ) = 1 − e − ( t η ) β Q(t) = 1 - e^{- \left( \frac{t}{\eta} \right)^{\beta}} Q ( t ) = 1 − e − ( η t ) β
当 Q = 10 % Q=10\% Q = 10% t = 16.5 t=16.5 t = 16.5
在均值为 16.5 的时间上建立正态置信限 由于 X 轴采用自然对数尺度 ln ( t ) \ln(t) ln ( t ) ln ( 16.5 ) \ln(16.5) ln ( 16.5 ) V a r ( ln ( t ^ ) ) Var(\ln(\widehat{t})) Va r ( ln ( t ))
令 u = ln ( t ) u=\ln(t) u = ln ( t )
u U = u ^ + z α 2 ⋅ V a r ( u ^ ) u_{U} = \widehat{u} + z_{\frac{\alpha}{2}} \cdot \sqrt{Var\left( \widehat{u} \right)} u U = u + z 2 α ⋅ Va r ( u )
u L = u ^ − z α 2 ⋅ V a r ( u ^ ) u_{L} = \widehat{u} - z_{\frac{\alpha}{2}} \cdot \sqrt{Var\left( \widehat{u} \right)} u L = u − z 2 α ⋅ Va r ( u )
已知 V a r ( β ^ ) Var(\widehat{\beta}) Va r ( β ) V a r ( η ^ ) Var(\widehat{\eta}) Va r ( η ) V a r ( u ^ ) Var(\widehat{u}) Va r ( u )
由威布尔 CDF 线性化:
l n l n ( 1 1 − Q ( t ) ) = β [ l n ( t ) − l n ( η ) ] lnln\left( \frac{1}{1 - Q(t)} \right) = \beta\left\lbrack ln(t) - ln(\eta) \right\rbrack l n l n ( 1 − Q ( t ) 1 ) = β [ l n ( t ) − l n ( η ) ]
u = l n ( t ) = 1 β l n l n ( 1 1 − Q ( t ) ) + l n ( η ) u=ln(t)=\frac{1}{\beta}lnln\left( \frac{1}{1 - Q(t)} \right)+ln(\eta) u = l n ( t ) = β 1 l n l n ( 1 − Q ( t ) 1 ) + l n ( η )
利用 Delta 方法:
V a r ( u ) = ( ∂ u ∂ β ) 2 V a r ( β ) + ( ∂ u ∂ η ) 2 V a r ( η ) + 2 ( ∂ u ∂ β ) ( ∂ u ∂ η ) C o v ( β , η ) Var(u) = \left( \frac{\partial u}{\partial\beta} \right)^{2}Var(\beta) + \left( \frac{\partial u}{\partial\eta} \right)^{2}Var(\eta) + 2\left( \frac{\partial u}{\partial\beta} \right)\left( \frac{\partial u}{\partial\eta} \right)Cov(\beta,\eta) Va r ( u ) = ( ∂ β ∂ u ) 2 Va r ( β ) + ( ∂ η ∂ u ) 2 Va r ( η ) + 2 ( ∂ β ∂ u ) ( ∂ η ∂ u ) C o v ( β , η )
= 1 β 4 ( l n l n ( 1 ( 1 − Q ) ) ) 2 V a r ( β ) + ( 1 η ) 2 V a r ( η ) − 2 η β 2 ( l n l n ( 1 ( 1 − Q ) ) ) C o v ( β , η ) = \frac{1}{\beta^{4}}\left( lnln\left( \frac{1}{(1 - Q)} \right) \right)^{2}Var(\beta) + \left( \frac{1}{\eta} \right)^{2}Var(\eta) - \frac{2}{{\eta\beta}^{2}}\left( lnln\left( \frac{1}{(1 - Q)} \right) \right)Cov(\beta,\eta) = β 4 1 ( l n l n ( ( 1 − Q ) 1 ) ) 2 Va r ( β ) + ( η 1 ) 2 Va r ( η ) − η β 2 2 ( l n l n ( ( 1 − Q ) 1 ) ) C o v ( β , η )
代入:
V a r ( β ^ ) = 1.215 , V a r ( η ^ ) = 76.42 , Q = 0.1 , β ^ = 2.55 , η ^ = 39.9 Var(\widehat{\beta})=1.215,\quad Var(\widehat{\eta})=76.42,\quad Q=0.1,\quad \widehat{\beta}=2.55,\quad \widehat{\eta}=39.9 Va r ( β ) = 1.215 , Va r ( η ) = 76.42 , Q = 0.1 , β = 2.55 , η = 39.9
得到:
V a r ( u ^ ) = 0.1854 Var(\widehat{u})=0.1854 Va r ( u ) = 0.1854
u ^ = ln ( 16.5 ) = 2.804 \widehat{u}=\ln(16.5)=2.804 u = ln ( 16.5 ) = 2.804
因此:
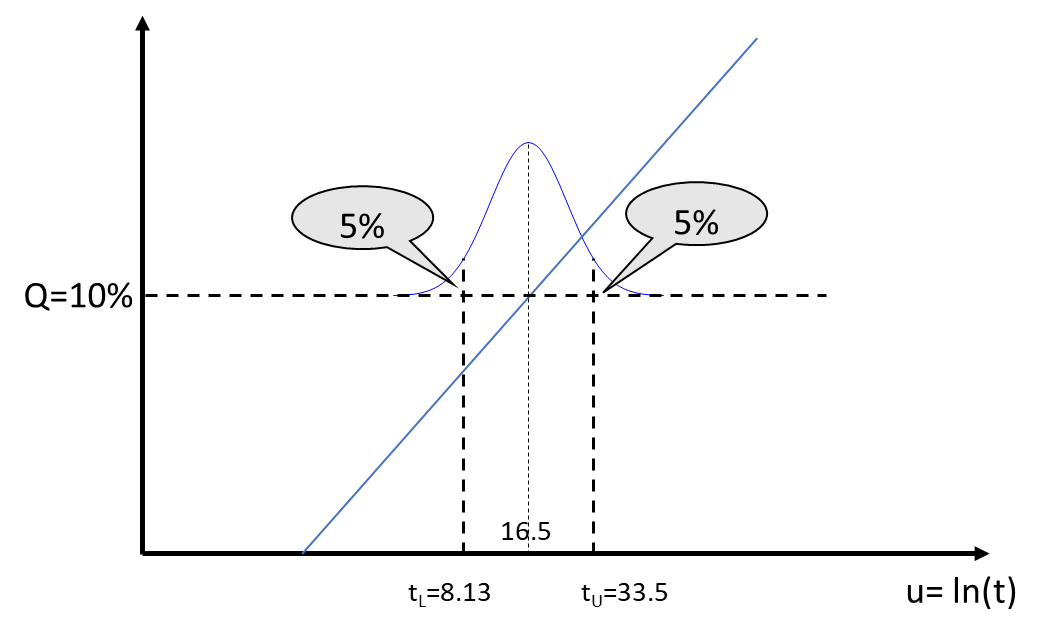
u U = 3.513 , u L = 2.096 u_U=3.513,\qquad u_L=2.096 u U = 3.513 , u L = 2.096
由于 u = ln ( t ) u=\ln(t) u = ln ( t ) t = exp ( u ) t=\exp(u) t = exp ( u )
t U = exp ( u U ) = 33.5 t_U=\exp(u_U)=33.5 t U = exp ( u U ) = 33.5
t L = exp ( u L ) = 8.13 t_L=\exp(u_L)=8.13 t L = exp ( u L ) = 8.13
Q 等于 10% 时,时间的 90% Fisher 矩阵双侧置信限 在 Q = 10 % Q=10\% Q = 10% t t t
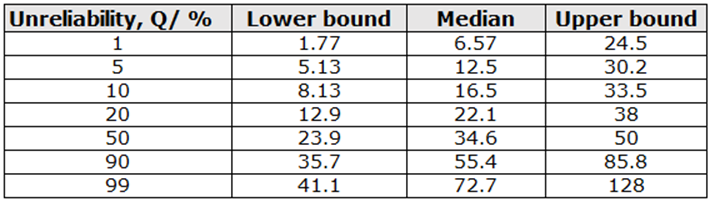
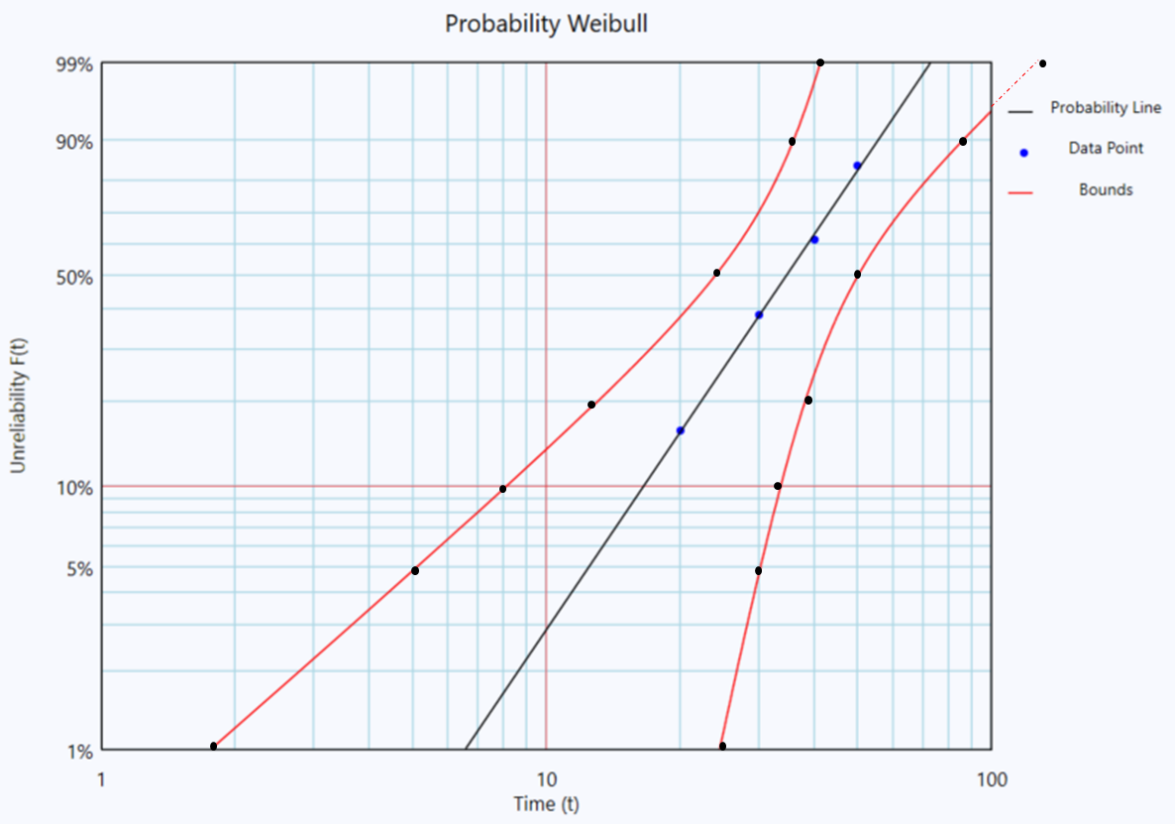
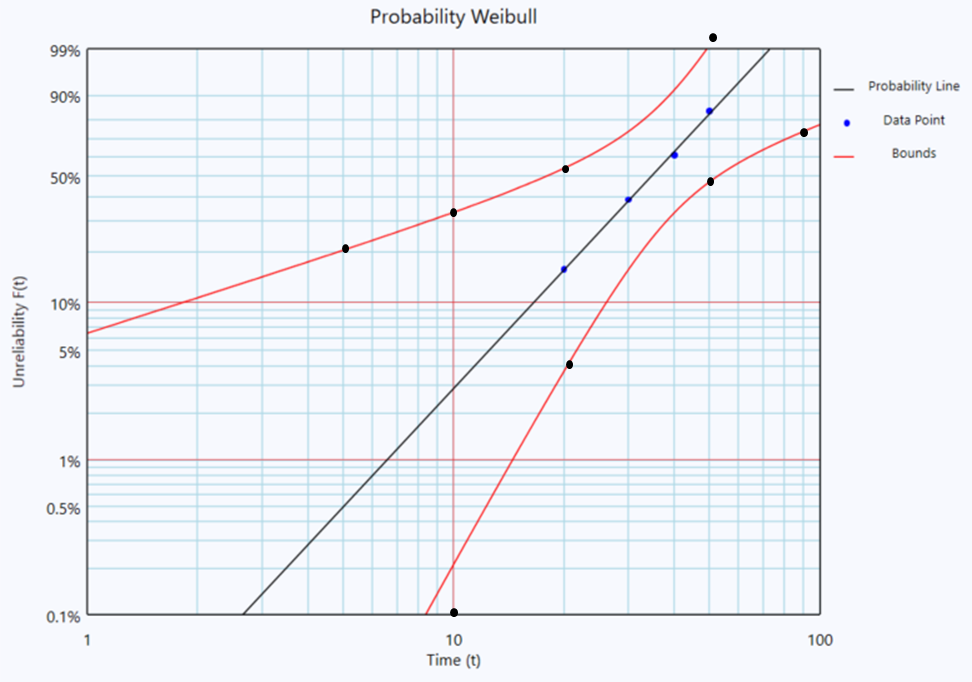
不同不可靠度下时间的 90% 置信限 将概率图上的各点连接起来,即得到置信限曲线:
时间的 Fisher 矩阵置信限 可靠度的 Fisher 矩阵置信限 将数据集 {20, 30, 40, 50} 拟合至二参数威布尔分布,求时间 t = 20 t=20 t = 20
RRX 解为:β = 2.55 \beta=2.55 β = 2.55 η = 39.9 \eta=39.9 η = 39.9 t = 20 t=20 t = 20 Q = 15.8 % Q=15.8\% Q = 15.8%
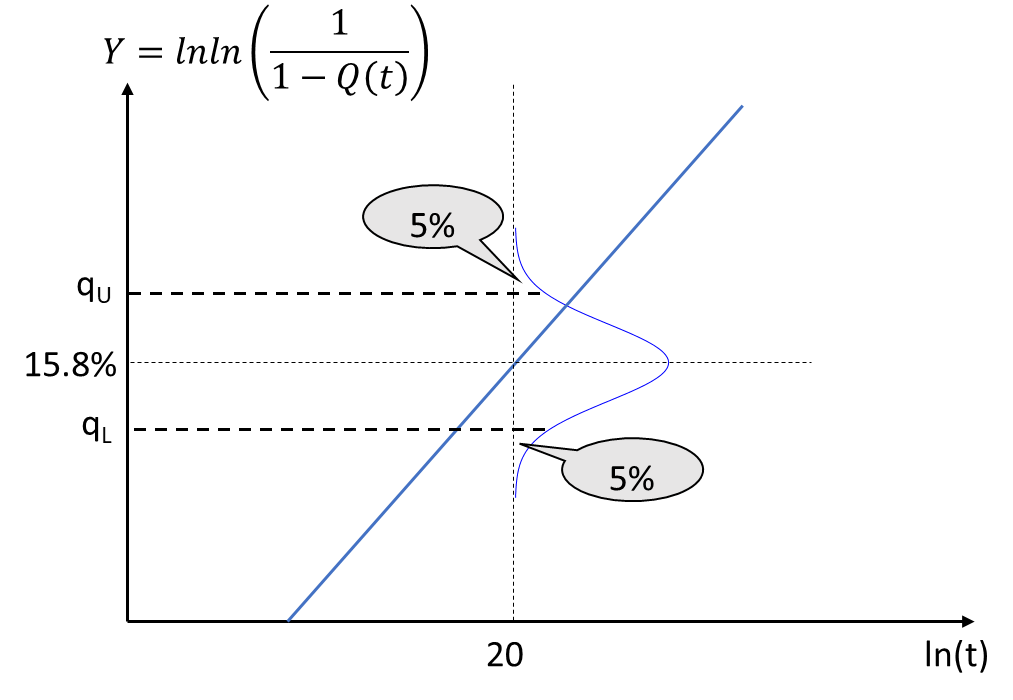
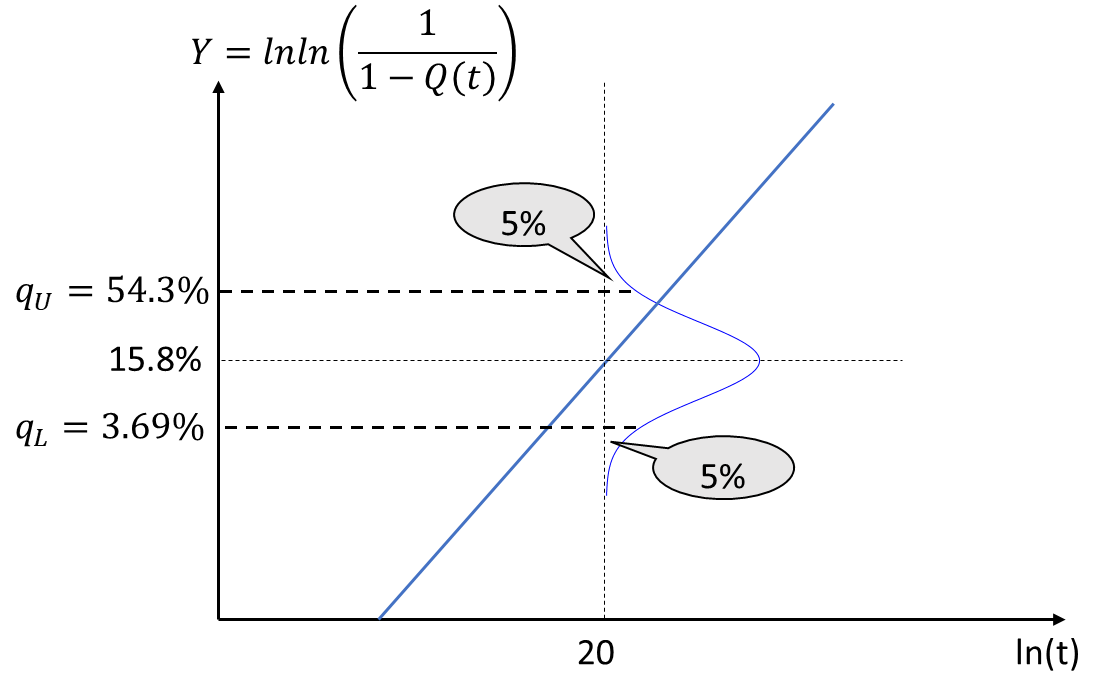
以下在均值为 15.8% 的不可靠度上建立正态置信限:
在均值为 0.158 的不可靠度上建立正态置信限 由于 Y 轴采用双对数倒数尺度 l n l n ( 1 / ( 1 − Q ( t ) ) ) lnln(1/(1-Q(t))) l n l n ( 1/ ( 1 − Q ( t ))) l n l n ( 1 / ( 1 − 0.158 ) ) lnln(1/(1-0.158)) l n l n ( 1/ ( 1 − 0.158 ))
令:
u = l n l n ( 1 1 − Q ( t ) ) u = lnln\left( \frac{1}{1 - Q(t)} \right) u = l n l n ( 1 − Q ( t ) 1 )
则:
u U = u ^ + z α 2 ⋅ V a r ( u ^ ) u_{U} = \widehat{u} + z_{\frac{\alpha}{2}} \cdot \sqrt{Var\left( \widehat{u} \right)} u U = u + z 2 α ⋅ Va r ( u )
u L = u ^ − z α 2 ⋅ V a r ( u ^ ) u_{L} = \widehat{u} - z_{\frac{\alpha}{2}} \cdot \sqrt{Var\left( \widehat{u} \right)} u L = u − z 2 α ⋅ Va r ( u )
由威布尔 CDF 线性化:
u = β [ l n ( t ) − l n ( η ) ] u=\beta\left\lbrack ln(t)-ln(\eta)\right\rbrack u = β [ l n ( t ) − l n ( η ) ]
应用 Delta 方法:
V a r ( u ) = ( ln ( t ) − l n ( η ) ) 2 V a r ( β ) + ( β η ) 2 V a r ( η ) − 2 β η ( ln ( t ) − l n ( η ) ) C o v ( β , η ) Var(u) = \left( \ln(t) - ln(\eta) \right)^{2}Var(\beta) + \left( \frac{\beta}{\eta} \right)^{2}Var(\eta) - \frac{2\beta}{\eta}\left( \ln(t) - ln(\eta) \right)Cov(\beta,\eta) Va r ( u ) = ( ln ( t ) − l n ( η ) ) 2 Va r ( β ) + ( η β ) 2 Va r ( η ) − η 2 β ( ln ( t ) − l n ( η ) ) C o v ( β , η )
代入 V a r ( β ^ ) = 1.215 Var(\widehat{\beta})=1.215 Va r ( β ) = 1.215 V a r ( η ^ ) = 76.42 Var(\widehat{\eta})=76.42 Va r ( η ) = 76.42 t = 20 t=20 t = 20 β ^ = 2.55 \widehat{\beta}=2.55 β = 2.55 η ^ = 39.9 \widehat{\eta}=39.9 η = 39.9
V a r ( u ^ ) = 0.8513 Var(\widehat{u})=0.8513 Va r ( u ) = 0.8513
u ^ = − 1.762 \widehat{u}=-1.762 u = − 1.762
得到:
u U = − 0.2447 , u L = − 3.280 u_U=-0.2447,\qquad u_L=-3.280 u U = − 0.2447 , u L = − 3.280
再将变换尺度转换回不可靠度,得到:
q U = 0.543 , q L = 0.0369 q_U=0.543,\qquad q_L=0.0369 q U = 0.543 , q L = 0.0369
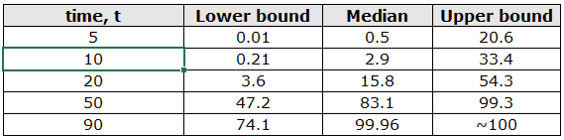
时间 t 等于 20 时不可靠度的 90% Fisher 矩阵双侧置信限 对不同时间 t t t
不同时间下不可靠度 Q 的 90% 置信限
叠加在概率图上的不可靠度置信限 似然比原理 似然比置信限以似然比检验为基础。以下以估计数据所拟合的威布尔分布形状参数 β \beta β
似然比统计量为:
Λ ( β ) = − 2 ln ( L ( β , η ^ ) L ( β ^ , η ^ ) ) = − 2 [ ln ( L ( β , η ^ ) ) − l n ( L ( β ^ , η ^ ) ) ] \small\Lambda(\beta) = - 2\ln\left( \frac{L\left( \beta,\widehat{\eta} \right)}{L\left( \widehat{\beta},\widehat{\eta} \right)} \right) = - 2\left\lbrack \ln\left( L\left( \beta,\widehat{\eta} \right) \right) - ln\left( L\left( \widehat{\beta},\widehat{\eta} \right) \right) \right\rbrack Λ ( β ) = − 2 ln ( L ( β , η ) L ( β , η ) ) = − 2 [ ln ( L ( β , η ) ) − l n ( L ( β , η ) ) ]
其中:
L ( β , η ^ ) L(\beta,\widehat{\eta}) L ( β , η ) η \eta η η ^ \widehat{\eta} η L ( β ^ , η ^ ) L(\widehat{\beta},\widehat{\eta}) L ( β , η ) 二参数威布尔分布的似然函数为:
L ( β , η ) = ∏ i = 1 n [ ( β η ( t i η ) β − 1 ) δ i ⋅ e x p ( − ( t i η ) β ) ] \small L(\beta,\eta) = \prod_{i = 1}^{n}\left\lbrack \left( \frac{\beta}{\eta}\left( \frac{t_{i}}{\eta} \right)^{\beta - 1} \right)^{\delta_{i}} \cdot exp\left( - \left( \frac{t_{i}}{\eta} \right)^{\beta} \right) \right\rbrack L ( β , η ) = ∏ i = 1 n [ ( η β ( η t i ) β − 1 ) δ i ⋅ e x p ( − ( η t i ) β ) ]
对于小样本,Λ ( β ) \Lambda(\beta) Λ ( β )
在 100 ( 1 − α ) % 100(1-\alpha)\% 100 ( 1 − α ) %
Λ ( β ) ≤ χ 1 , 1 − α 2 \Lambda(\beta) \leq \chi_{1,1 - \alpha}^{2} Λ ( β ) ≤ χ 1 , 1 − α 2
因此,β \beta β β \beta β
− 2 [ ln ( L ( β , η ^ ) ) − l n ( L ( β ^ , η ^ ) ) ] = χ 1 , 1 − α 2 - 2\left\lbrack \ln\left( L\left( \beta,\widehat{\eta} \right) \right) - ln\left( L\left( \widehat{\beta},\widehat{\eta} \right) \right) \right\rbrack = \chi_{1,1 - \alpha}^{2} − 2 [ ln ( L ( β , η ) ) − l n ( L ( β , η ) ) ] = χ 1 , 1 − α 2
示例
将数据集 {20, 30, 40, 50} 拟合至二参数威布尔分布,采用似然比法求 β \beta β
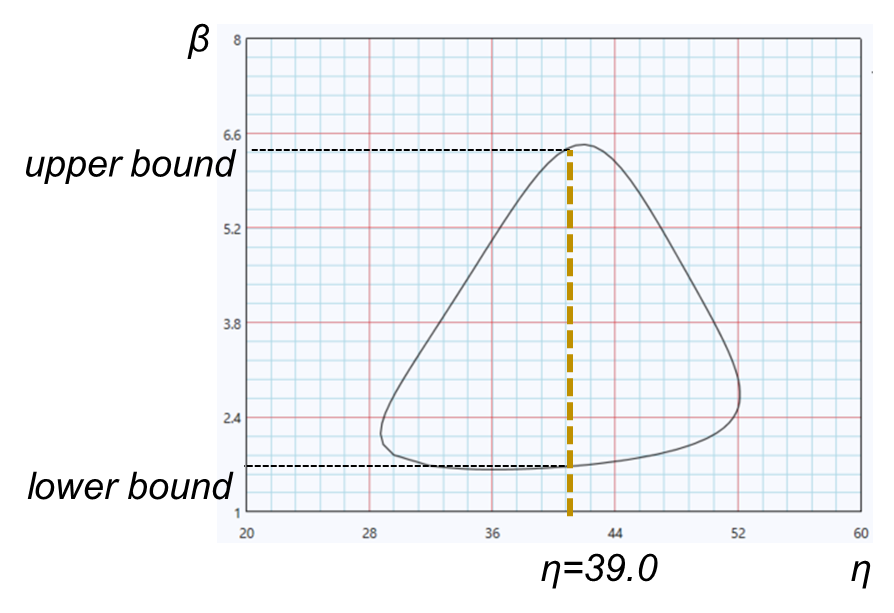
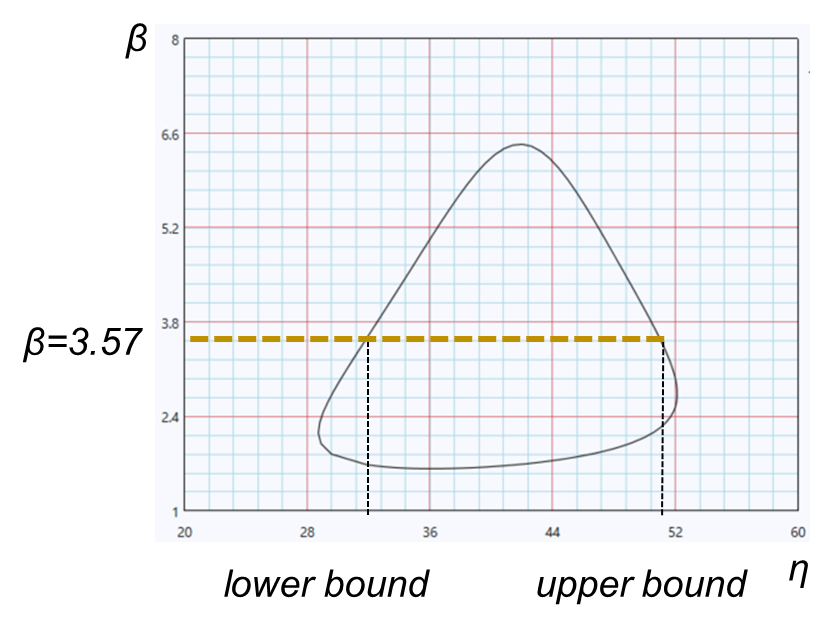
MLE 解为:β = 3.57 \beta=3.57 β = 3.57 η = 39 \eta=39 η = 39
求解满足以下等式的 β \beta β
− 2 [ ln ( L ( β , 39 ) ) − l n ( L ( 3.57 , 39 ) ) ] = χ 1 , 0.9 2 \small- 2\left\lbrack \ln\left( L(\beta,39) \right) - ln\left( L(3.57,\ 39) \right) \right\rbrack = \chi_{1,0.9}^{2} − 2 [ ln ( L ( β , 39 ) ) − l n ( L ( 3.57 , 39 ) ) ] = χ 1 , 0.9 2
由临界卡方值约束的 beta 似然比置信限 由此得到 β \beta β η \eta η
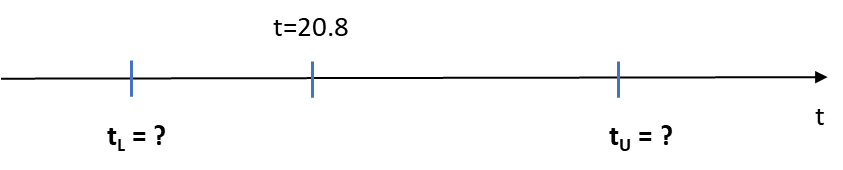
由临界卡方值约束的 eta 似然比置信限 时间的置信限 考虑相同的数据集 {20, 30, 40, 50},拟合至二参数威布尔分布。其 B(10) 寿命为 t = 20.8 t=20.8 t = 20.8 Q ( t = 20.8 ) = 10 % Q(t=20.8)=10\% Q ( t = 20.8 ) = 10%
时间的似然比置信限示例数据 以时间 t t t
Λ ( t ) = − 2 ln ( L ( t , β ^ ) L ( t ^ , β ^ ) ) = − 2 [ ln ( L ( t , β ^ ) ) − l n ( L ( t ^ , β ^ ) ) ] \small\Lambda(t) = - 2\ln\left( \frac{L\left( t,\widehat{\beta} \right)}{L\left( \widehat{t},\widehat{\beta} \right)} \right) = - 2\left\lbrack \ln\left( L\left( t,\widehat{\beta} \right) \right) - ln\left( L\left( \widehat{t},\widehat{\beta} \right) \right) \right\rbrack Λ ( t ) = − 2 ln ( L ( t , β ) L ( t , β ) ) = − 2 [ ln ( L ( t , β ) ) − l n ( L ( t , β ) ) ]
其中:
L ( t , β ^ ) L(t,\widehat{\beta}) L ( t , β ) β \beta β β ^ \widehat{\beta} β L ( t ^ , β ^ ) L(\widehat{t},\widehat{\beta}) L ( t , β ) β \beta β L ( β ^ , η ^ ) L(\widehat{\beta},\widehat{\eta}) L ( β , η ) L ( t , β ) L(t,\beta) L ( t , β ) L ( β , η ) L(\beta,\eta) L ( β , η )
η = t ^ [ ln ( 1 1 − Q ) ] 1 β \eta = \frac{\widehat{t}}{\left\lbrack \ln\left( \frac{1}{1 - Q} \right) \right\rbrack^{\frac{1}{\beta}}} η = [ l n ( 1 − Q 1 ) ] β 1 t
对于完整数据:
L ( β , t ) = ∏ i = i N ( β η ) ( t η ) β − 1 e − ( t η ) β L(\beta,t) = \prod_{i = i}^{N}\left( \frac{\beta}{\eta} \right)\left( \frac{t}{\eta} \right)^{\beta - 1}e^{- \left( \frac{t}{\eta} \right)^{\beta}} L ( β , t ) = ∏ i = i N ( η β ) ( η t ) β − 1 e − ( η t ) β
其中 Q = 0.1 Q=0.1 Q = 0.1 t t t
− 2 [ ln ( L ( t , 3.57 ) ) − l n ( L ( 20.8 , 3.57 ) ) ] = χ 1 , 0.9 2 - 2\left\lbrack \ln\left( L(t,3.57) \right) - ln\left( L(20.8,\ 3.57) \right) \right\rbrack = \chi_{1,0.9}^{2} − 2 [ ln ( L ( t , 3.57 ) ) − l n ( L ( 20.8 , 3.57 ) ) ] = χ 1 , 0.9 2
由临界卡方值约束的时间似然比等高线
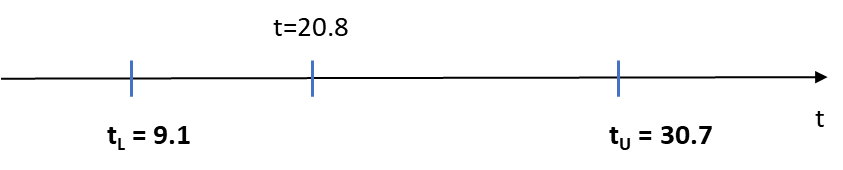
时间的似然比置信限 其含义是:在 90% 置信水平下,预计总体中 10% 的单元将在 9.1 至 30.7 单位时间之间失效。
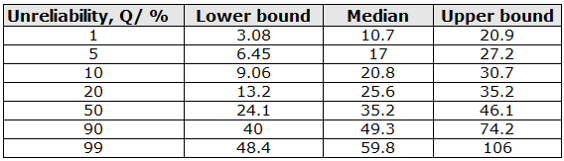
在 Q = 10 % Q=10\% Q = 10%
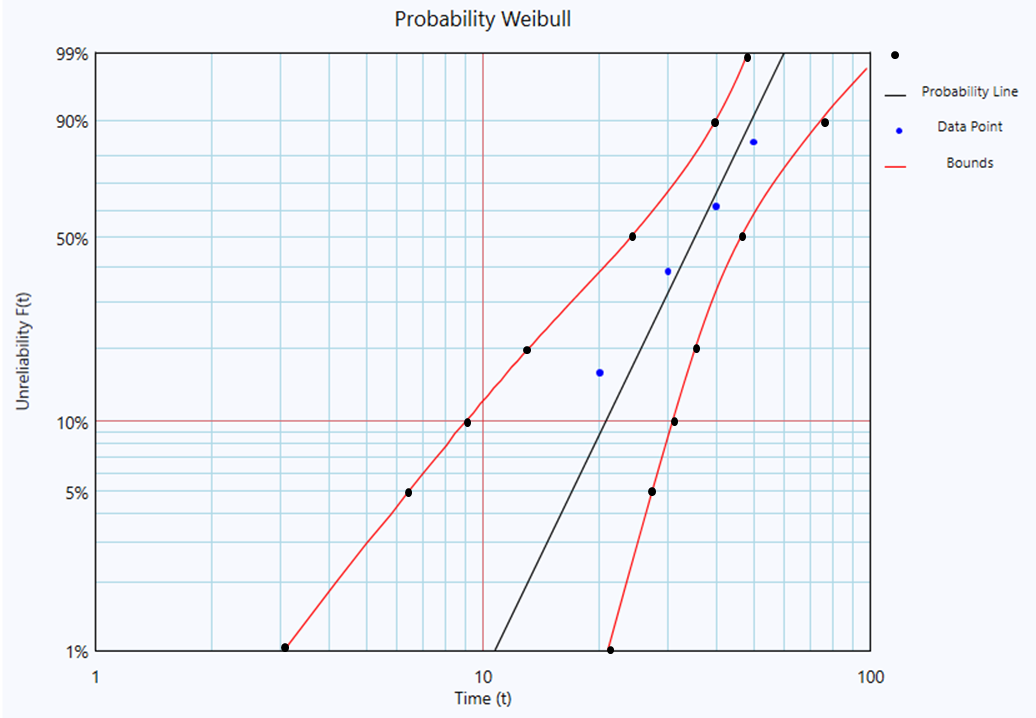
不同不可靠度下时间的 90% 似然比置信限 将概率图上的各点连接起来,即得到置信限曲线:
似然比置信限 可靠度的置信限 给定时间 t t t
Λ ( Q ) = − 2 ln ( L ( Q , β ^ ) L ( Q ^ , β ^ ) ) = − 2 [ ln ( L ( Q , β ^ ) ) − l n ( L ( Q ^ , β ^ ) ) ] \Lambda(Q) = - 2\ln\left( \frac{L\left( Q,\widehat{\beta} \right)}{L\left( \widehat{Q},\widehat{\beta} \right)} \right) = - 2\left\lbrack \ln\left( L\left( Q,\widehat{\beta} \right) \right) - ln\left( L\left( \widehat{Q},\widehat{\beta} \right) \right) \right\rbrack Λ ( Q ) = − 2 ln ( L ( Q , β ) L ( Q , β ) ) = − 2 [ ln ( L ( Q , β ) ) − l n ( L ( Q , β ) ) ]
L ( Q , β ) L(Q,\beta) L ( Q , β ) L ( β , η ) L(\beta,\eta) L ( β , η )
η = t ^ [ ln ( 1 1 − Q ) ] 1 β \eta = \frac{\widehat{t}}{\left\lbrack \ln\left( \frac{1}{1 - Q} \right) \right\rbrack^{\frac{1}{\beta}}} η = [ l n ( 1 − Q 1 ) ] β 1 t
对于完整数据:
L ( β , t ) = ∏ i = i N ( β η ) ( t η ) β − 1 e − ( t η ) β L(\beta,t) = \prod_{i = i}^{N}\left( \frac{\beta}{\eta} \right)\left( \frac{t}{\eta} \right)^{\beta - 1}e^{- \left( \frac{t}{\eta} \right)^{\beta}} L ( β , t ) = ∏ i = i N ( η β ) ( η t ) β − 1 e − ( η t ) β
考虑同一数据集,在 t = 20 t=20 t = 20 Q = 8.81 % Q=8.81\% Q = 8.81%
不可靠度置信限的示例数据 求满足以下等式的最大和最小 Q:
− 2 [ ln ( L ( Q , 3.57 ) ) − l n ( L ( 0.0881 , 3.57 ) ) ] = χ 1 , 0.9 2 - 2\left\lbrack \ln\left( L(Q,3.57) \right) - ln\left( L(0.0881,\ 3.57) \right) \right\rbrack = \chi_{1,0.9}^{2} − 2 [ ln ( L ( Q , 3.57 ) ) − l n ( L ( 0.0881 , 3.57 ) ) ] = χ 1 , 0.9 2
由临界卡方值约束的不可靠度似然比等高线
不可靠度的似然比置信限 在 t = 20 t=20 t = 20
模拟置信限通过重复生成合成数据集,近似评估拟合分布参数和由其推导的可靠性指标的抽样不确定性。本节所称的模拟是参数自助法(parametric bootstrap) :每个合成数据集均由已拟合的寿命分布生成,而不是直接从原始观测值中重复抽样。
模拟结果可用于计算分布参数、指定时间的可靠度,或 B(10) 等寿命分位数的置信限。这些置信限反映在给定分布和估计方法条件下,由现有样本引起的不确定性;它们不能反映分布模型选择不当、数据缺乏代表性,或删失假设错误所造成的影响。
方法 拟合原始数据。 选择寿命分布和估计方法,例如极大似然估计(MLE)或 X 方向秩回归(RRX),并利用观测数据估计模型参数。生成参数自助样本。 根据拟合分布生成足够多的合成寿命数据集,数量记为 N N N 重新估计模型。 使用与原始数据相同的分布和估计方法拟合每个合成数据集,从而得到 N N N 计算百分位置信限。 对每次拟合计算关注的指标,例如可靠度 R ( t ) R(t) R ( t ) N N N 算例 将完整失效数据集 {20, 30, 40, 50} 拟合至二参数威布尔分布。目标是采用参数自助法,在威布尔概率图上建立下单侧 90% 逐点置信限曲线。
1. 拟合原始数据
采用 RRX 得到的参数估计值为 β ^ = 2.55 \widehat{\beta}=2.55 β = 2.55 η ^ = 39.9 \widehat{\eta}=39.9 η = 39.9
2. 生成参数自助样本
根据拟合的二参数威布尔分布生成 N = 1,000 N=1{,}000 N = 1 , 000 N N N
3. 重新估计参数
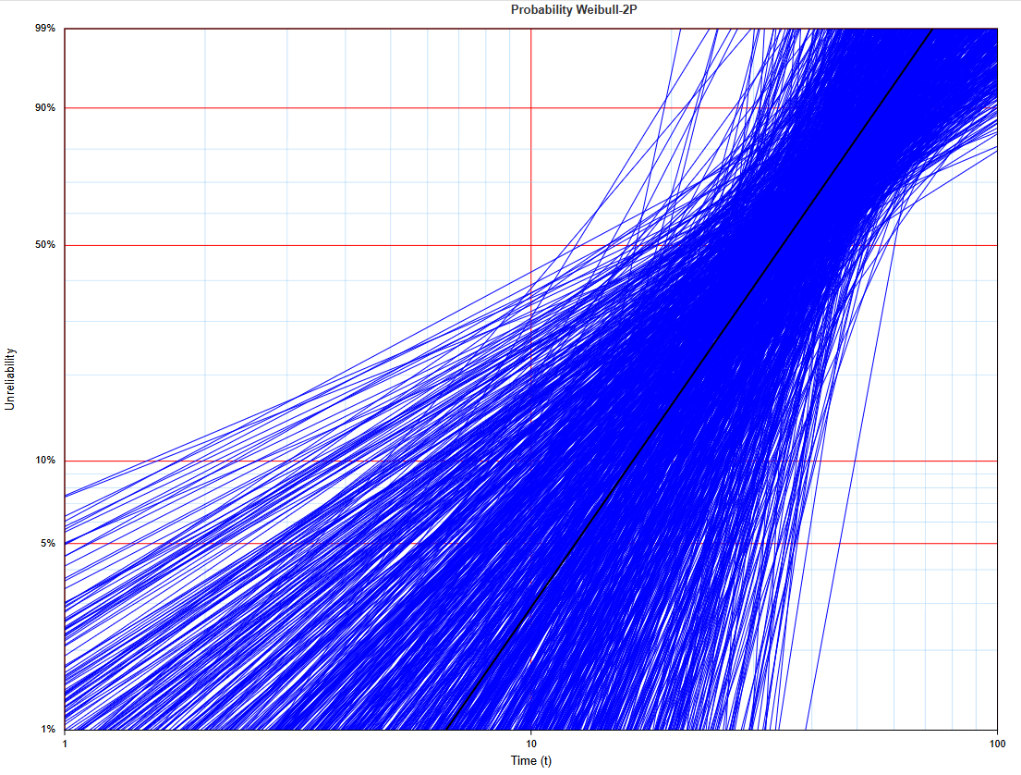
使用 RRX 将每个合成数据集重新拟合至二参数威布尔分布。每次拟合都会得到一组新的 β \beta β η \eta η
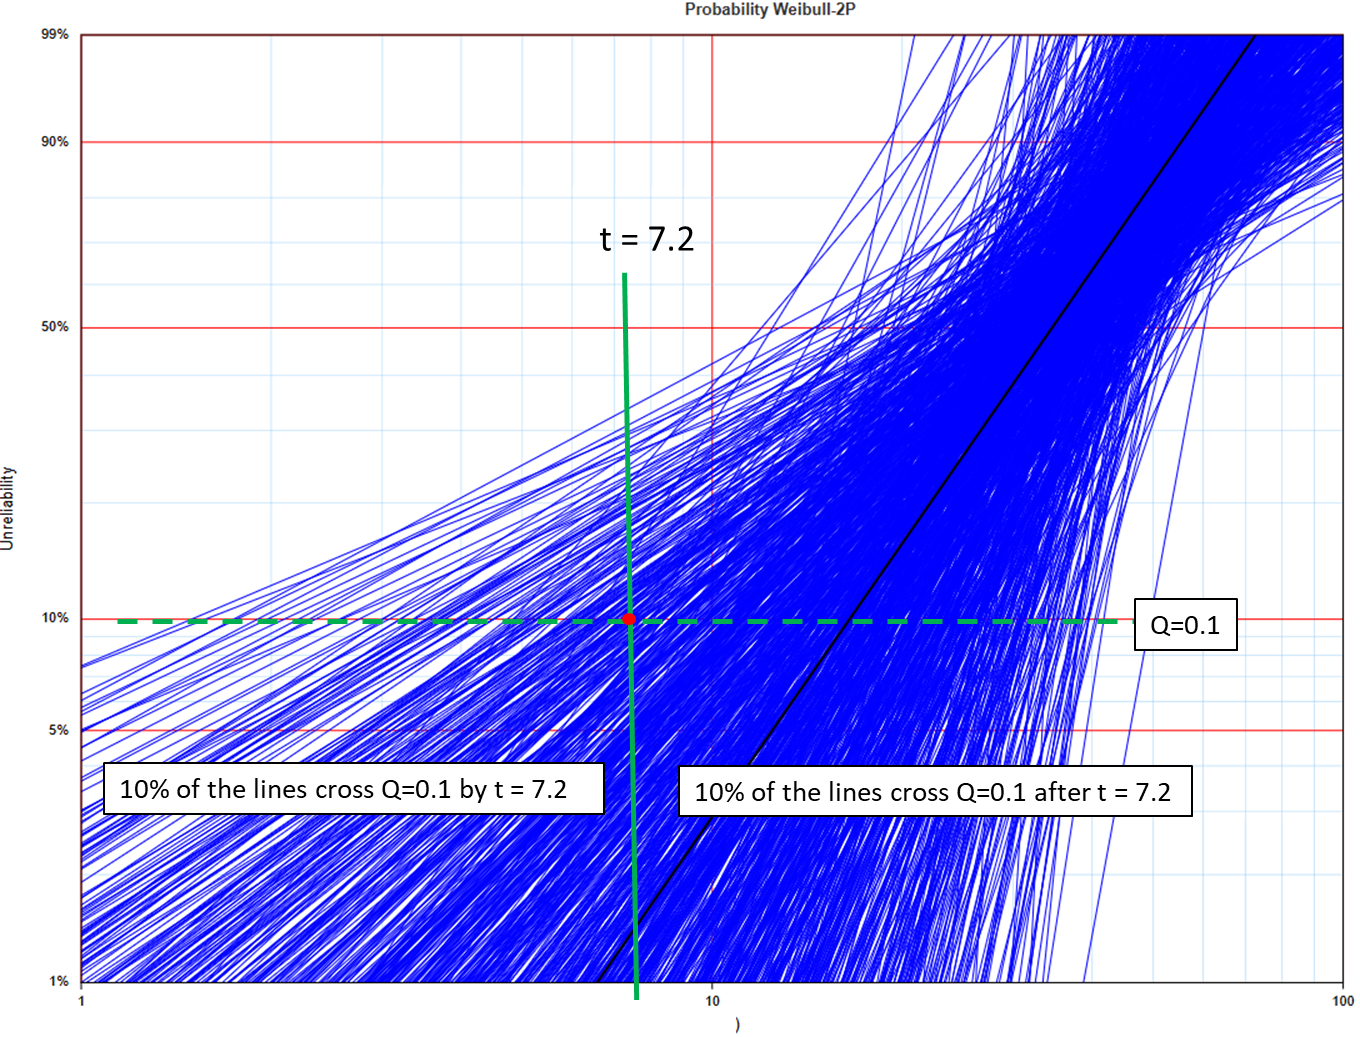
由 1,000 个参数自助样本得到的威布尔拟合直线;每个样本包含四个失效时间 计算每次自助拟合的 B(10) 寿命,并将 1,000 个结果由小到大排序。下单侧 90% 置信限是该分布的第 10 百分位数;当 N = 1,000 N=1{,}000 N = 1 , 000 t = 7.2 t=7.2 t = 7.2
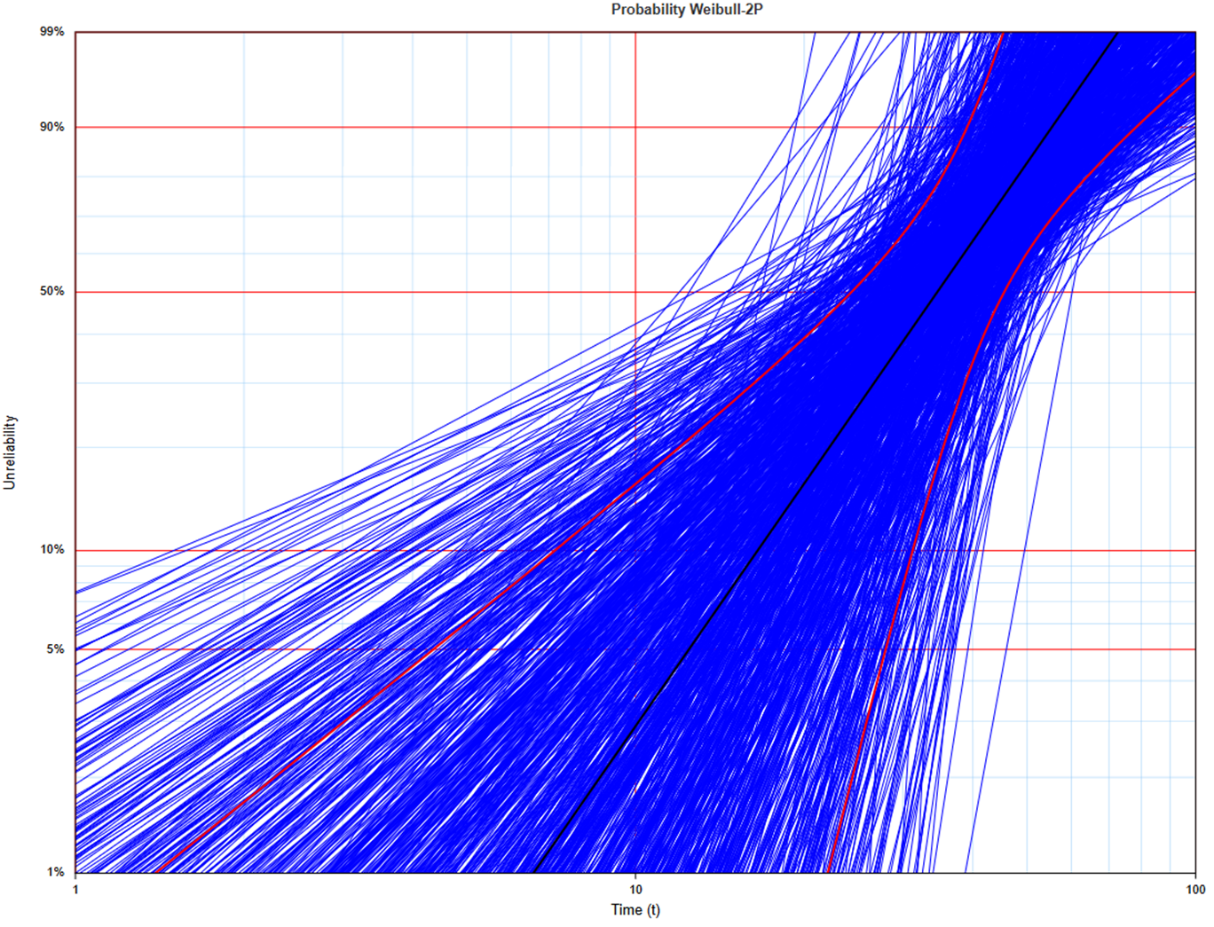
B(10) 的下单侧 90% 置信限,即自助 B(10) 估计值的第 10 百分位数 对 B(1)、B(2)、…、B(99) 重复上述计算。在每个不可靠度水平上,选取相应自助寿命估计值的第 10 百分位数。连接这些点即可得到下单侧 90% 逐点置信限曲线。这里的“逐点”非常重要:90% 置信水平分别适用于每一个不可靠度水平,并不表示整条拟合分布曲线有 90% 的概率包含在该置信限内。
成对显示的下、上单侧 90% 逐点置信限 图 66 显示 FreeWeibull.com 提供的下、上单侧 90% 置信限。在每个不可靠度水平上,下限曲线取自助寿命估计值的第 10 百分位数,上限曲线取第 90 百分位数。因此,两条曲线之间包含中间 80% 的自助估计值,相当于中心双侧 80% 百分位区间。它不应被解释为传统的双侧 90% 置信区间;后者应采用第 5 和第 95 百分位数。
寿命数据分析关注只经历一次失效的系统,记录其失效时间或当前未失效年龄;复现数据分析(Recurring Data Analysis,RDA)则处理系统随时间可能多次失效的情况。它特别适用于可修复系统,需要分析失效趋势和可靠性随时间变化的场景。
使用 NHPP 模型的动机
从可靠性角度看,非齐次泊松过程(Non-Homogeneous Poisson Process,NHPP)适用于分析可修复系统,主要用途包括:
识别系统失效强度的变化趋势。 支持维修和大修决策。 为可靠性仿真和 RAM 研究中的数字孪生分析提供统计模型,例如应用于 AeROS。 幂律非齐次泊松过程 常用于描述可修复系统。它能够表示系统随时间改善(例如开发过程中的系统)或恶化(例如现场运行系统)的情况。
修复使系统恢复至“与故障前一样差”的状态,即最小修复。 首次失效时间服从威布尔分布。 系统具有无限多个潜在失效模式。 对于在给定时间区间内期望发生 λ \lambda λ n n n
P [ N = n ] = λ n e − λ n ! P\lbrack N = n\rbrack = \frac{\lambda^{n}e^{- \lambda}}{n!} P [ N = n ] = n ! λ n e − λ
若 λ \lambda λ
Λ ( t ) = λ ^ t β ^ \Lambda(t) = \widehat{\lambda}t^{\widehat{\beta}} Λ ( t ) = λ t β
则失效强度为 Λ ( t ) \Lambda(t) Λ ( t )
u ( t ) = λ β t β − 1 u(t) = \lambda\beta t^{\beta - 1} u ( t ) = λ β t β − 1
随机变量 N ( t ) N(t) N ( t ) n n n
P [ N ( t ) = n ] = ( Λ ( t ) ) n e − Λ ( t ) n ! P\left\lbrack N(t) = n \right\rbrack = \frac{\left( \Lambda(t) \right)^{n}e^{- \Lambda(t)}}{n!} P [ N ( t ) = n ] = n ! ( Λ ( t ) ) n e − Λ ( t )
这里使用“失效强度”而不是“失效率”,以区别于寿命数据分析中的用法。
年龄为 t t t d d d t + d t+d t + d R ( d / t ) R(d/t) R ( d / t )
R ( d / t ) = e − [ λ ( t + d ) β − λ t β ] R(d/t) = e^{- \left\lbrack {\lambda(t + d)}^{\beta} - \lambda t^{\beta} \right\rbrack} R ( d / t ) = e − [ λ ( t + d ) β − λ t β ]
若把强度函数重新参数化为威布尔失效率函数:
u ( t ) = β η ( t η ) β − 1 u(t) = \frac{\beta}{\eta}\left( \frac{t}{\eta} \right)^{\beta - 1} u ( t ) = η β ( η t ) β − 1
则:
η = ( 1 λ ) 1 β \eta = \left( \frac{1}{\lambda} \right)^{\frac{1}{\beta}} η = ( λ 1 ) β 1
这进一步说明首次失效时间服从威布尔分布,而后续失效服从 NHPP 模型。
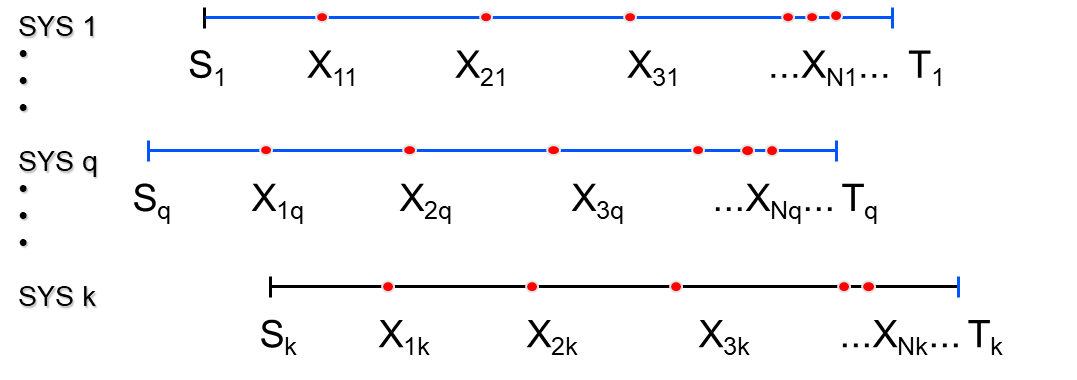
为估计 NHPP 模型的 λ \lambda λ β \beta β k k k q q q q = 1 , … , k q=1,\ldots,k q = 1 , … , k S q S_q S q T q T_q T q N q N_q N q q q q X i q X_{iq} X i q i i i
k 个系统的复现失效 λ \lambda λ β \beta β
λ ^ = ∑ q = 1 k N q ∑ q = 1 k ( T q β ^ − S q β ^ ) \small{\widehat{\lambda} = \frac{\sum_{q = 1}^{k}N_{q}}{\sum_{q = 1}^{k}\left( T_{q}^{\widehat{\beta}} - S_{q}^{\widehat{\beta}} \right)}
} λ = ∑ q = 1 k ( T q β − S q β ) ∑ q = 1 k N q β ^ = ∑ q = 1 k N q λ ^ ∑ q = 1 k [ ( T q β ^ ln ( T q ) − S q β ^ ln ( S q ) ) ] − ∑ q = 1 k ∑ i = 1 N q ln ( X i q ) {\widehat{\beta} = \frac{\sum_{q = 1}^{k}N_{q}}{\widehat{\lambda}\sum_{q = 1}^{k}{\left\lbrack \left( T_{q}^{\widehat{\beta}}\ln\left( T_{q} \right) - S_{q}^{\widehat{\beta}}\ln\left( S_{q} \right) \right) \right\rbrack - \sum_{q = 1}^{k}{\sum_{i = 1}^{N_{q}}{\ln\left( X_{iq} \right)}}}}} β = λ ∑ q = 1 k [ ( T q β ln ( T q ) − S q β ln ( S q ) ) ] − ∑ q = 1 k ∑ i = 1 N q ln ( X i q ) ∑ q = 1 k N q 由于这些方程没有闭式解,必须采用迭代方法求解 λ \lambda λ β \beta β
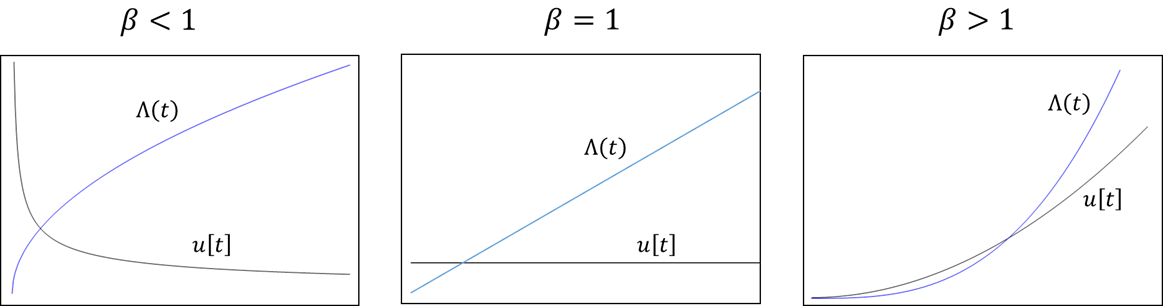
β \beta β
beta 对失效强度的影响 β < 1 \beta<1 β < 1 β = 1 \beta=1 β = 1 β > 1 \beta>1 β > 1 示例:泵失效数据
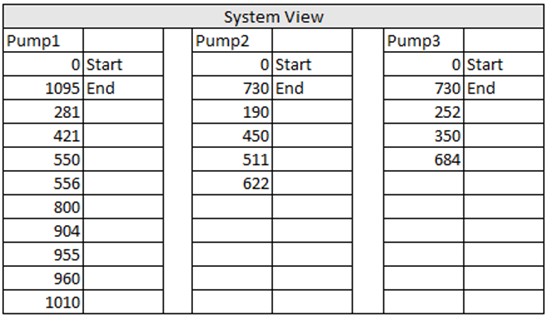
考虑三台在相似应力条件下运行的泵。每台泵在指定运行期间经历多次失效。
三台泵的失效记录
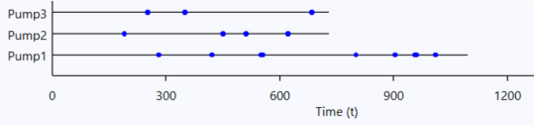
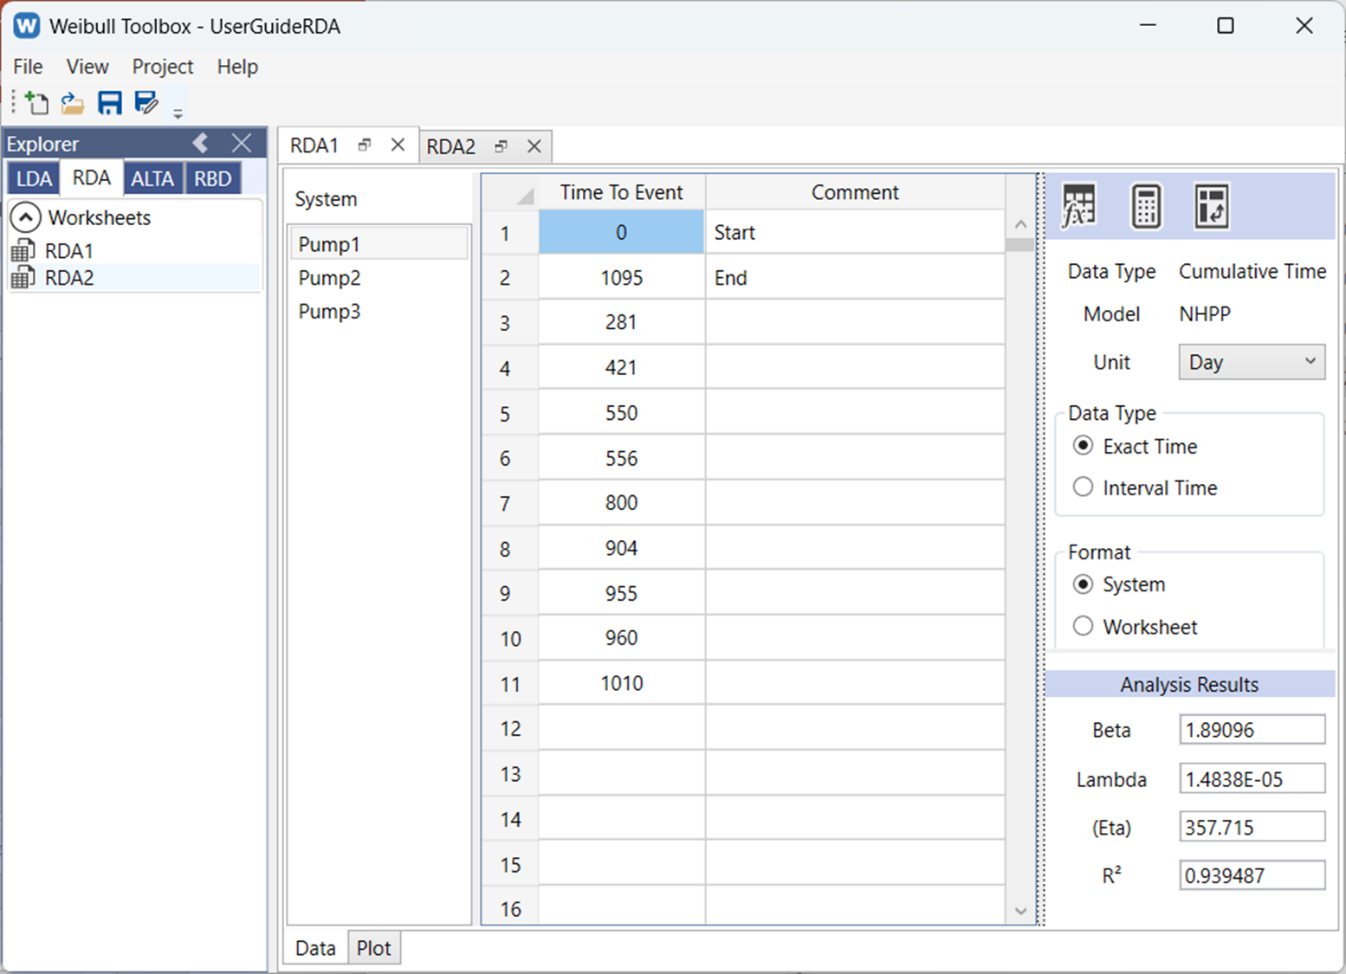
失效时间线 将累积失效记录(天)输入 Weibull Toolbox 的 RDA 工作表。
RDA 工作表 NHPP 参数的 MLE 解为:
λ ^ = 0.0000148 / 天 \widehat{\lambda} = 0.0000148\ /\text{天} λ = 0.0000148 / 天
β ^ = 1.89 \widehat{\beta} = 1.89 β = 1.89
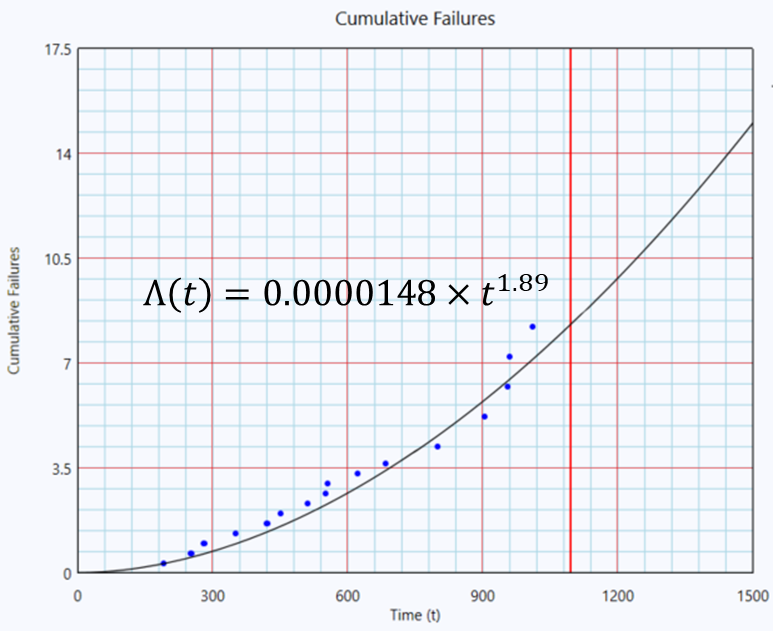
利用这些参数,可绘制累积失效次数(均值函数)和失效强度随时间的变化。
累积失效次数函数:
Λ ( t ) = λ ^ t β ^ = 0.0000148 × t 1.89 \Lambda(t) = \widehat{\lambda}t^{\widehat{\beta}} = 0.0000148 \times t^{1.89} Λ ( t ) = λ t β = 0.0000148 × t 1.89
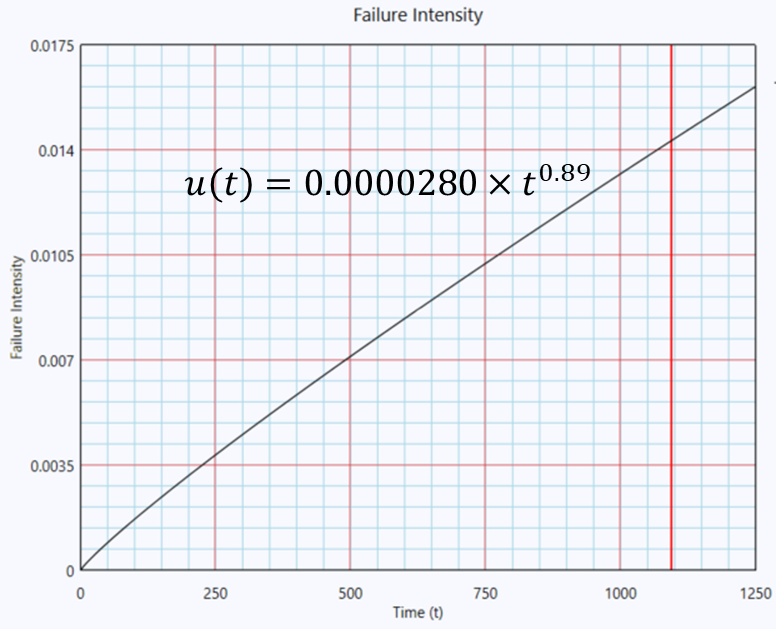
累积失效次数随时间变化 失效强度函数:
u ( t ) = λ β t β − 1 = 0.0000280 × t 0.89 u(t) = \lambda\beta t^{\beta - 1} = 0.0000280 \times t^{0.89} u ( t ) = λ β t β − 1 = 0.0000280 × t 0.89
失效强度随时间变化 由重复失效数据估计得到的参数存在抽样不确定性。置信限为模型参数以及由拟合模型推导的量提供合理取值范围,包括预期累积失效次数、失效强度和瞬时 MTBF。
本节采用 Fisher 信息矩阵进行计算。对数似然函数在极大似然估计值附近的曲率,可用于近似计算 λ ^ \widehat{\lambda} λ β ^ \widehat{\beta} β
截至时间 t t t
Λ ( t ) = λ t β \Lambda(t)=\lambda t^{\beta} Λ ( t ) = λ t β
相应的失效强度,即失效发生率,为:
u ( t ) = λ β t β − 1 u(t)=\lambda\beta t^{\beta-1} u ( t ) = λ β t β − 1
本节所用符号定义如下。
符号 定义 Λ ( t ) \Lambda(t) Λ ( t ) 从时间 0 到时间 t t t u ( t ) u(t) u ( t ) 时间 t t t λ \lambda λ 尺度系数;λ > 0 \lambda>0 λ > 0 β \beta β 描述失效强度趋势的形状参数;β > 0 \beta>0 β > 0 k k k 数据集中可修复系统的数量 S q S_q S q 系统 q q q T q T_q T q 系统 q q q X i q X_{iq} X i q 系统 q q q i i i N q N_q N q 系统 q q q n n n 所有系统的观测失效总数,n = ∑ q = 1 k N q n=\sum_{q=1}^{k}N_q n = ∑ q = 1 k N q
从时间 0 开始观察至时间 T T T k = 1 k=1 k = 1 S 1 = 0 S_1=0 S 1 = 0 T 1 = T T_1=T T 1 = T
每个系统 q q q ( S q , T q ] (S_q,T_q] ( S q , T q ]
ℓ ( λ , β ) = n ln λ + n ln β + ( β − 1 ) ∑ q = 1 k ∑ i = 1 N q ln X i q − λ ∑ q = 1 k ( T q β − S q β ) \ell(\lambda,\beta)
=n\ln\lambda+n\ln\beta
+(\beta-1)\sum_{q=1}^{k}\sum_{i=1}^{N_q}\ln X_{iq}
-\lambda\sum_{q=1}^{k}\left(T_q^{\beta}-S_q^{\beta}\right) ℓ ( λ , β ) = n ln λ + n ln β + ( β − 1 ) q = 1 ∑ k i = 1 ∑ N q ln X i q − λ q = 1 ∑ k ( T q β − S q β ) 全文使用自然对数。当系统从时间零开始观察,即 S q = 0 S_q=0 S q = 0
极大似然估计值 λ ^ \widehat{\lambda} λ β ^ \widehat{\beta} β
λ = n ∑ q = 1 k ( T q β − S q β ) \lambda=\frac{n}{\displaystyle\sum_{q=1}^{k}\left(T_q^{\beta}-S_q^{\beta}\right)} λ = q = 1 ∑ k ( T q β − S q β ) n β = n λ ∑ q = 1 k ( T q β ln T q − S q β ln S q ) − ∑ q = 1 k ∑ i = 1 N q ln X i q \beta=
\frac{n}{
\displaystyle
\lambda\sum_{q=1}^{k}\left(T_q^{\beta}\ln T_q-S_q^{\beta}\ln S_q\right)
-\sum_{q=1}^{k}\sum_{i=1}^{N_q}\ln X_{iq}} β = λ q = 1 ∑ k ( T q β ln T q − S q β ln S q ) − q = 1 ∑ k i = 1 ∑ N q ln X i q n 与参数估计一节相同,这些方程需要采用迭代方法求解;当 S q = 0 S_q=0 S q = 0
观测 Fisher 信息由 ℓ ( λ , β ) \ell(\lambda,\beta) ℓ ( λ , β )
I λ λ = n λ ^ , 2 I_{\lambda\lambda}=\frac{n}{\widehat{\lambda}^{,2}} I λλ = λ , 2 n
I λ β = ∑ q = 1 k ( T q β ^ ln T q − S q β ^ ln S q ) I_{\lambda\beta}
=\sum_{q=1}^{k}\left(T_q^{\widehat{\beta}}\ln T_q-S_q^{\widehat{\beta}}\ln S_q\right) I λ β = q = 1 ∑ k ( T q β ln T q − S q β ln S q ) I β β = n β ^ , 2 + λ ^ ∑ q = 1 k [ T q β ^ ( ln T q ) 2 − S q β ^ ( ln S q ) 2 ] I_{\beta\beta}
=\frac{n}{\widehat{\beta}^{,2}}
+\widehat{\lambda}\sum_{q=1}^{k}
\left[
T_q^{\widehat{\beta}}(\ln T_q)^2
-S_q^{\widehat{\beta}}(\ln S_q)^2
\right] I ββ = β , 2 n + λ q = 1 ∑ k [ T q β ( ln T q ) 2 − S q β ( ln S q ) 2 ] ( λ ^ , β ^ ) (\widehat{\lambda},\widehat{\beta}) ( λ , β )
D = I λ λ I β β − I λ β , 2 D=I_{\lambda\lambda}I_{\beta\beta}-I_{\lambda\beta}^{,2} D = I λλ I ββ − I λ β , 2
则:
Var ( λ ^ ) = I β β D \operatorname{Var}(\widehat{\lambda})=\frac{I_{\beta\beta}}{D} Var ( λ ) = D I ββ
Var ( β ^ ) = I λ λ D \operatorname{Var}(\widehat{\beta})=\frac{I_{\lambda\lambda}}{D} Var ( β ) = D I λλ
Cov ( λ ^ , β ^ ) = − I λ β D \operatorname{Cov}(\widehat{\lambda},\widehat{\beta})=-\frac{I_{\lambda\beta}}{D} Cov ( λ , β ) = − D I λ β
当所求置信限同时依赖两个参数时,必须保留协方差项。以上方差和协方差均位于参数的原始尺度;在建立置信限时才引入对数尺度。
对于 100 ( 1 − α ) % 100(1-\alpha)\% 100 ( 1 − α ) % z z z
双侧置信限使用 z = z 1 − α / 2 z=z_{1-\alpha/2} z = z 1 − α /2 z = 1.96 z=1.96 z = 1.96 下单侧、上单侧以及同时显示的上下单侧置信限使用 z = z 1 − α z=z_{1-\alpha} z = z 1 − α z = 1.645 z=1.645 z = 1.645 由于 λ \lambda λ β \beta β
Var ( ln λ ^ ) ≈ Var ( λ ^ ) λ ^ , 2 \operatorname{Var}(\ln\widehat{\lambda})
\approx\frac{\operatorname{Var}(\widehat{\lambda})}{\widehat{\lambda}^{,2}} Var ( ln λ ) ≈ λ , 2 Var ( λ ) Var ( ln β ^ ) ≈ Var ( β ^ ) β ^ , 2 \operatorname{Var}(\ln\widehat{\beta})
\approx\frac{\operatorname{Var}(\widehat{\beta})}{\widehat{\beta}^{,2}} Var ( ln β ) ≈ β , 2 Var ( β ) 参数置信限为:
λ L = λ ^ exp [ − z Var ( λ ^ ) λ ^ ] , λ U = λ ^ exp [ + z Var ( λ ^ ) λ ^ ] \lambda_L=\widehat{\lambda}\exp\left[-\frac{z\sqrt{\operatorname{Var}(\widehat{\lambda})}}{\widehat{\lambda}}\right],
\qquad
\lambda_U=\widehat{\lambda}\exp\left[+\frac{z\sqrt{\operatorname{Var}(\widehat{\lambda})}}{\widehat{\lambda}}\right] λ L = λ exp − λ z Var ( λ ) , λ U = λ exp + λ z Var ( λ ) β L = β ^ exp [ − z Var ( β ^ ) β ^ ] , β U = β ^ exp [ + z Var ( β ^ ) β ^ ] \beta_L=\widehat{\beta}\exp\left[-\frac{z\sqrt{\operatorname{Var}(\widehat{\beta})}}{\widehat{\beta}}\right],
\qquad
\beta_U=\widehat{\beta}\exp\left[+\frac{z\sqrt{\operatorname{Var}(\widehat{\beta})}}{\widehat{\beta}}\right] β L = β exp − β z Var ( β ) , β U = β exp + β z Var ( β ) 每一种置信限类型都计算上下两个限值。双侧显示和上下单侧同时显示会给出两个限值;下单侧显示只给出下限,上单侧显示只给出上限。单侧以及上下单侧同时显示均采用单侧分位数。
在时间 t > 0 t>0 t > 0
Λ ^ ( t ) = λ ^ t β ^ \widehat{\Lambda}(t)=\widehat{\lambda}t^{\widehat{\beta}} Λ ( t ) = λ t β
所需偏导数为:
∂ Λ ∂ λ = t β \frac{\partial\Lambda}{\partial\lambda}=t^{\beta} ∂ λ ∂ Λ = t β
∂ Λ ∂ β = Λ ( t ) ln t \frac{\partial\Lambda}{\partial\beta}=\Lambda(t)\ln t ∂ β ∂ Λ = Λ ( t ) ln t
近似方差为:
Var ( Λ ^ ( t ) ) = ( ∂ Λ ∂ λ ) 2 Var ( λ ^ ) + ( ∂ Λ ∂ β ) 2 Var ( β ^ ) + 2 ( ∂ Λ ∂ λ ) ( ∂ Λ ∂ β ) Cov ( λ ^ , β ^ ) \operatorname{Var}\!\left(\widehat{\Lambda}(t)\right)
=\left(\frac{\partial\Lambda}{\partial\lambda}\right)^2\operatorname{Var}(\widehat{\lambda})
+\left(\frac{\partial\Lambda}{\partial\beta}\right)^2\operatorname{Var}(\widehat{\beta})
+2\left(\frac{\partial\Lambda}{\partial\lambda}\right)
\left(\frac{\partial\Lambda}{\partial\beta}\right)
\operatorname{Cov}(\widehat{\lambda},\widehat{\beta}) Var ( Λ ( t ) ) = ( ∂ λ ∂ Λ ) 2 Var ( λ ) + ( ∂ β ∂ Λ ) 2 Var ( β ) + 2 ( ∂ λ ∂ Λ ) ( ∂ β ∂ Λ ) Cov ( λ , β ) 逐点置信限为:
Λ L ( t ) = Λ ^ ( t ) exp [ − z Var ( Λ ^ ( t ) ) Λ ^ ( t ) ] \Lambda_L(t)=\widehat{\Lambda}(t)
\exp\left[-\frac{z\sqrt{\operatorname{Var}(\widehat{\Lambda}(t))}}{\widehat{\Lambda}(t)}\right] Λ L ( t ) = Λ ( t ) exp − Λ ( t ) z Var ( Λ ( t )) Λ U ( t ) = Λ ^ ( t ) exp [ + z Var ( Λ ^ ( t ) ) Λ ^ ( t ) ] \Lambda_U(t)=\widehat{\Lambda}(t)
\exp\left[+\frac{z\sqrt{\operatorname{Var}(\widehat{\Lambda}(t))}}{\widehat{\Lambda}(t)}\right] Λ U ( t ) = Λ ( t ) exp + Λ ( t ) z Var ( Λ ( t )) 把方差除以 Λ ^ ( t ) 2 \widehat{\Lambda}(t)^2 Λ ( t ) 2 ln Λ ^ ( t ) \ln\widehat{\Lambda}(t) ln Λ ( t )
在时间 t > 0 t>0 t > 0
u ^ ( t ) = λ ^ β ^ t β ^ − 1 \widehat{u}(t)=\widehat{\lambda}\widehat{\beta}t^{\widehat{\beta}-1} u ( t ) = λ β t β − 1
其偏导数为:
∂ u ∂ λ = β t β − 1 \frac{\partial u}{\partial\lambda}=\beta t^{\beta-1} ∂ λ ∂ u = β t β − 1
∂ u ∂ β = λ t β − 1 ( 1 + β ln t ) \frac{\partial u}{\partial\beta}=\lambda t^{\beta-1}(1+\beta\ln t) ∂ β ∂ u = λ t β − 1 ( 1 + β ln t )
近似方差为:
Var ( u ^ ( t ) ) = ( ∂ u ∂ λ ) 2 Var ( λ ^ ) + ( ∂ u ∂ β ) 2 Var ( β ^ ) + 2 ( ∂ u ∂ λ ) ( ∂ u ∂ β ) Cov ( λ ^ , β ^ ) \operatorname{Var}(\widehat{u}(t))
=\left(\frac{\partial u}{\partial\lambda}\right)^2\operatorname{Var}(\widehat{\lambda})
+\left(\frac{\partial u}{\partial\beta}\right)^2\operatorname{Var}(\widehat{\beta})
+2\left(\frac{\partial u}{\partial\lambda}\right)
\left(\frac{\partial u}{\partial\beta}\right)
\operatorname{Cov}(\widehat{\lambda},\widehat{\beta}) Var ( u ( t )) = ( ∂ λ ∂ u ) 2 Var ( λ ) + ( ∂ β ∂ u ) 2 Var ( β ) + 2 ( ∂ λ ∂ u ) ( ∂ β ∂ u ) Cov ( λ , β ) 置信限为:
u L ( t ) = u ^ ( t ) exp [ − z Var ( u ^ ( t ) ) u ^ ( t ) ] u_L(t)=\widehat{u}(t)
\exp\left[-\frac{z\sqrt{\operatorname{Var}(\widehat{u}(t))}}{\widehat{u}(t)}\right] u L ( t ) = u ( t ) exp [ − u ( t ) z Var ( u ( t )) ] u U ( t ) = u ^ ( t ) exp [ + z Var ( u ^ ( t ) ) u ^ ( t ) ] u_U(t)=\widehat{u}(t)
\exp\left[+\frac{z\sqrt{\operatorname{Var}(\widehat{u}(t))}}{\widehat{u}(t)}\right] u U ( t ) = u ( t ) exp [ + u ( t ) z Var ( u ( t )) ] 对于失效强度随时间变化的系统,将失效强度的倒数称为瞬时 MTBF:
MTBF ^ i n s t ( t ) = 1 u ^ ( t ) \widehat{\operatorname{MTBF}}_{\mathrm{inst}}(t)=\frac{1}{\widehat{u}(t)} MTBF inst ( t ) = u ( t ) 1 取倒数会使上下限次序互换:
MTBF i n s t , L ( t ) = 1 u U ( t ) , MTBF i n s t , U ( t ) = 1 u L ( t ) \operatorname{MTBF}_{\mathrm{inst},L}(t)=\frac{1}{u_U(t)},
\qquad
\operatorname{MTBF}_{\mathrm{inst},U}(t)=\frac{1}{u_L(t)} MTBF inst , L ( t ) = u U ( t ) 1 , MTBF inst , U ( t ) = u L ( t ) 1 该指标是时间 t t t β = 1 \beta=1 β = 1
这些置信限描述 NHPP 模型平均行为估计值的不确定性,并不是未来失效次数的预测限。未来的失效次数仍会围绕均值函数随机变化,并服从所假设的泊松过程。
Fisher 矩阵法对极大似然点附近的似然曲面采用局部正态近似。随着观测失效次数增加,其准确性通常会提高。当失效次数较少、参数估计值高度相关或似然曲面明显不对称时,该近似的准确性可能较低。
置信限也不能弥补模型选择不当所造成的问题。在把置信限用于预测、维修规划或经济决策之前,应先评估幂律 NHPP 模型的假设及拟合优度。
整个分析必须采用一致的时间单位。改变时间单位会改变 λ \lambda λ
当 β > 1 \beta>1 β > 1
令:
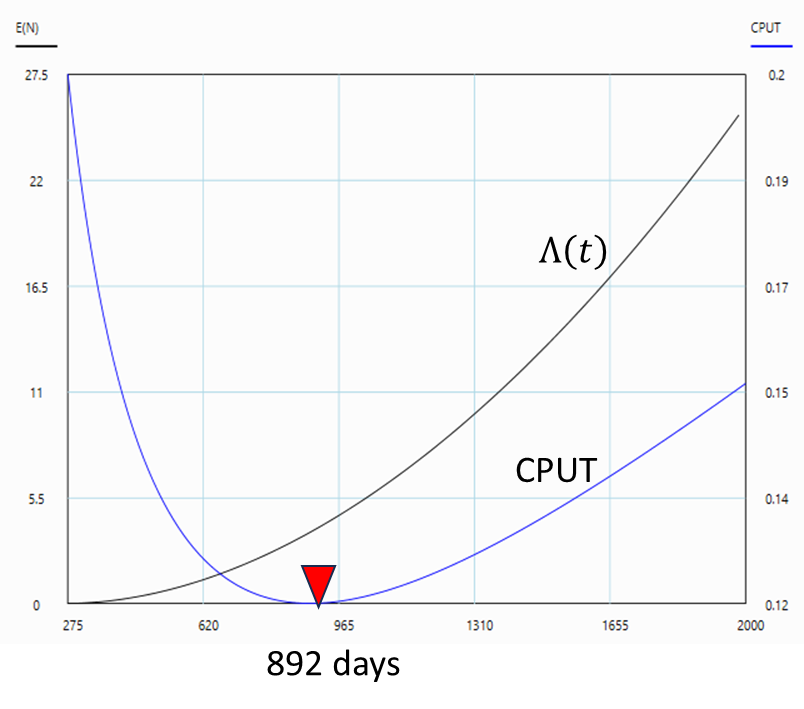
T O H T_{OH} T O H C C M C_{CM} C CM C O H C_{OH} C O H 单位时间成本(Cost per Unit Time,CPUT)定义为:
C P U T = [ C C M × Λ ( T O H ) + C O H ] T O H CPUT = \frac{\left\lbrack C_{CM} \times \Lambda\left( T_{OH} \right) + C_{OH} \right\rbrack}{T_{OH}} CP U T = T O H [ C CM × Λ ( T O H ) + C O H ]
其中:
Λ ( T O H ) = λ ^ ( T O H ) β ^ \Lambda\left( T_{OH} \right) = \widehat{\lambda}\left( T_{OH} \right)^{\widehat{\beta}} Λ ( T O H ) = λ ( T O H ) β
为求最佳 T O H T_{OH} T O H T O H T_{OH} T O H
d ( C P U T ) d T O H = 0 \frac{d(CPUT)}{dT_{OH}} = 0 d T O H d ( CP U T ) = 0
求解得到:
T O H = [ C O H λ ( β − 1 ) C C M ] 1 β T_{OH} = \left\lbrack \frac{C_{OH}}{\lambda(\beta - 1)C_{CM}} \right\rbrack^{\frac{1}{\beta}} T O H = [ λ ( β − 1 ) C CM C O H ] β 1
对于上述泵示例,修理成本为 $10,000,大修成本为 $50,000:
λ ^ = 0.0000148 / 天 , β ^ = 1.89 \widehat{\lambda}=0.0000148\ /\text{天},\qquad \widehat{\beta}=1.89 λ = 0.0000148 / 天 , β = 1.89
T O H = [ 50 , 000 0.0000148 × ( 1.89 − 1 ) × 10 , 000 ] 1 1.89 ≈ 892 {T_{OH} = \left\lbrack \frac{50,000}{0.0000148 \times (1.89 - 1) \times 10,000} \right\rbrack^{\frac{1}{1.89}}
}{\approx 892} T O H = [ 0.0000148 × ( 1.89 − 1 ) × 10 , 000 50 , 000 ] 1.89 1 ≈ 892 下图显示 CPUT 随大修时间的变化:
最佳大修时间 存在最佳大修间隔需要满足:
β > 1 \beta>1 β > 1 修理成本低于大修成本。 当 β < 1 \beta<1 β < 1
若修理成本高于大修成本,则系统发生失效时应进行更换。
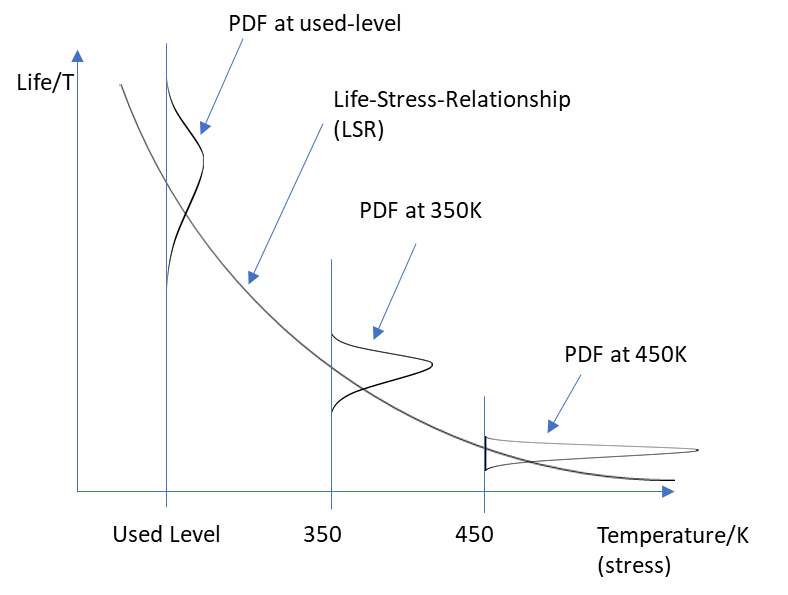
加速寿命试验(ALT)通过在高于正常使用条件的应力水平下测试产品,从而更快地获得可靠性信息。根据加速条件下收集的数据拟合寿命–应力关系,并据此估计预期使用条件下的寿命分布。
本节讨论恒定应力 ALT,包括精确失效时间、暂停数据(右删失观测)和区间删失观测。每个观测值都必须与施加于该试件的应力水平或应力组合相对应。
两个温度水平下的失效时间数据
失效时间(小时) 350 K 450 K
200 10 350 15 425 30 820 45 1200 65 1250 70 1300 85 1600 130 2000 195 2100 300
从加速应力水平外推至使用条件下的寿命分布 只有当所选应力所加速的失效机理与正常使用条件下发生的失效机理相同时,外推结果才有意义。在通常的尺度加速假设下,各应力水平的分布形状参数保持不变;应力改变时间尺度,但不改变分布类型。因此,随着寿命尺度向低应力使用条件增大,失效时间的绝对离散程度也可能增大,如上图所示。
ALT 分析需要:
包含观测时间、观测类型及相应应力值的数据集。 寿命分布,例如 Weibull、对数正态或指数分布。 与应力及失效机理相适合的寿命–应力关系。 用于估计寿命或可靠度的明确使用条件。 对于一个未知应力效应,数学上至少需要两个不同的应力水平才能识别模型。若有 p p p p + 1 p+1 p + 1
令 z i z_i z i i i i
ℓ = ∑ i = 1 N f ln f ( t i ∣ z i ) + ∑ i = 1 N s ln R ( t i ∣ z i ) + ∑ i = 1 N I ln [ R ( t L i ∣ z i ) − R ( t R i ∣ z i ) ] \ell=\sum_{i=1}^{N_f}\ln f(t_i\mid z_i)+\sum_{i=1}^{N_s}\ln R(t_i\mid z_i)+\sum_{i=1}^{N_I}\ln\left[R(t_{Li}\mid z_i)-R(t_{Ri}\mid z_i)\right] ℓ = i = 1 ∑ N f ln f ( t i ∣ z i ) + i = 1 ∑ N s ln R ( t i ∣ z i ) + i = 1 ∑ N I ln [ R ( t L i ∣ z i ) − R ( t R i ∣ z i ) ] 其中,N f N_f N f N s N_s N s N I N_I N I i i i t L i t_{Li} t L i t R i t_{Ri} t R i
当温度加速热激活失效机理时,通常采用 Arrhenius 关系:
L ( V ) = C exp ( B V ) L(V)=C\exp\left(\frac{B}{V}\right) L ( V ) = C exp ( V B )
其中,V V V C C C B B B L ( V ) L(V) L ( V ) V V V L ( V ) L(V) L ( V ) η ( V ) \eta(V) η ( V ) L ( V ) L(V) L ( V )
对于使用温度 V u V_u V u V a V_a V a
A F = L ( V u ) L ( V a ) = exp [ B ( 1 V u − 1 V a ) ] AF=\frac{L(V_u)}{L(V_a)}=\exp\left[B\left(\frac{1}{V_u}-\frac{1}{V_a}\right)\right] A F = L ( V a ) L ( V u ) = exp [ B ( V u 1 − V a 1 ) ]
对于各应力水平具有共同形状参数 β \beta β
f ( t , V ) = β η ( V ) [ t η ( V ) ] β − 1 exp [ − ( t η ( V ) ) β ] f(t,V)=\frac{\beta}{\eta(V)}\left[\frac{t}{\eta(V)}\right]^{\beta-1}\exp\left[-\left(\frac{t}{\eta(V)}\right)^\beta\right] f ( t , V ) = η ( V ) β [ η ( V ) t ] β − 1 exp [ − ( η ( V ) t ) β ]
R ( t , V ) = exp [ − ( t η ( V ) ) β ] , η ( V ) = C exp ( B V ) R(t,V)=\exp\left[-\left(\frac{t}{\eta(V)}\right)^\beta\right],\qquad \eta(V)=C\exp\left(\frac{B}{V}\right) R ( t , V ) = exp [ − ( η ( V ) t ) β ] , η ( V ) = C exp ( V B )
MLE 解包括 β \beta β B B B C C C
对于各应力水平具有共同对数尺度标准差 σ \sigma σ μ ( V ) = ln [ L ( V ) ] \mu(V)=\ln[L(V)] μ ( V ) = ln [ L ( V )]
f ( t , V ) = 1 t σ 2 π exp { − 1 2 [ ln t − μ ( V ) σ ] 2 } f(t,V)=\frac{1}{t\sigma\sqrt{2\pi}}\exp\left\{-\frac{1}{2}\left[\frac{\ln t-\mu(V)}{\sigma}\right]^2\right\} f ( t , V ) = t σ 2 π 1 exp { − 2 1 [ σ l n t − μ ( V ) ] 2 }
R ( t , V ) = 1 − Φ [ ln t − μ ( V ) σ ] , μ ( V ) = ln C + B V R(t,V)=1-\Phi\left[\frac{\ln t-\mu(V)}{\sigma}\right],\qquad \mu(V)=\ln C+\frac{B}{V} R ( t , V ) = 1 − Φ [ σ l n t − μ ( V ) ] , μ ( V ) = ln C + V B
MLE 解包括 B B B C C C σ \sigma σ
对于指数寿命分布,L ( V ) L(V) L ( V ) λ ( V ) = 1 / L ( V ) \lambda(V)=1/L(V) λ ( V ) = 1/ L ( V )
f ( t , V ) = 1 L ( V ) exp [ − t L ( V ) ] , R ( t , V ) = exp [ − t L ( V ) ] f(t,V)=\frac{1}{L(V)}\exp\left[-\frac{t}{L(V)}\right],\qquad R(t,V)=\exp\left[-\frac{t}{L(V)}\right] f ( t , V ) = L ( V ) 1 exp [ − L ( V ) t ] , R ( t , V ) = exp [ − L ( V ) t ]
L ( V ) = C exp ( B V ) , λ ( V ) = 1 C exp ( − B V ) L(V)=C\exp\left(\frac{B}{V}\right),\qquad \lambda(V)=\frac{1}{C}\exp\left(-\frac{B}{V}\right) L ( V ) = C exp ( V B ) , λ ( V ) = C 1 exp ( − V B )
MLE 解包括 B B B C C C β = 1 \beta=1 β = 1
当寿命近似随应力的幂次变化时,逆幂律(IPL)关系通常用于电压、载荷、压力或振动等非热应力:
L ( V ) = 1 K V n L(V)=\frac{1}{KV^n} L ( V ) = K V n 1
其中,V V V K K K n n n n n n
对于使用应力 V u V_u V u V a V_a V a
A F = L ( V u ) L ( V a ) = ( V a V u ) n AF=\frac{L(V_u)}{L(V_a)}=\left(\frac{V_a}{V_u}\right)^n A F = L ( V a ) L ( V u ) = ( V u V a ) n
对于具有共同形状参数 β \beta β
f ( t , V ) = β η ( V ) [ t η ( V ) ] β − 1 exp [ − ( t η ( V ) ) β ] f(t,V)=\frac{\beta}{\eta(V)}\left[\frac{t}{\eta(V)}\right]^{\beta-1}\exp\left[-\left(\frac{t}{\eta(V)}\right)^\beta\right] f ( t , V ) = η ( V ) β [ η ( V ) t ] β − 1 exp [ − ( η ( V ) t ) β ]
R ( t , V ) = exp [ − ( K V n t ) β ] , η ( V ) = 1 K V n R(t,V)=\exp\left[-\left(KV^nt\right)^\beta\right],\qquad \eta(V)=\frac{1}{KV^n} R ( t , V ) = exp [ − ( K V n t ) β ] , η ( V ) = K V n 1
MLE 解包括 β \beta β K K K n n n
对于具有共同对数尺度标准差 σ \sigma σ
f ( t , V ) = 1 t σ 2 π exp { − 1 2 [ ln t − μ ( V ) σ ] 2 } f(t,V)=\frac{1}{t\sigma\sqrt{2\pi}}\exp\left\{-\frac{1}{2}\left[\frac{\ln t-\mu(V)}{\sigma}\right]^2\right\} f ( t , V ) = t σ 2 π 1 exp { − 2 1 [ σ l n t − μ ( V ) ] 2 }
R ( t , V ) = 1 − Φ [ ln t − μ ( V ) σ ] , μ ( V ) = − ln K − n ln V R(t,V)=1-\Phi\left[\frac{\ln t-\mu(V)}{\sigma}\right],\qquad \mu(V)=-\ln K-n\ln V R ( t , V ) = 1 − Φ [ σ l n t − μ ( V ) ] , μ ( V ) = − ln K − n ln V
MLE 解包括 K K K n n n σ \sigma σ
对于指数寿命分布,L ( V ) L(V) L ( V ) λ ( V ) = 1 / L ( V ) \lambda(V)=1/L(V) λ ( V ) = 1/ L ( V )
f ( t , V ) = K V n exp ( − K V n t ) , R ( t , V ) = exp ( − K V n t ) f(t,V)=KV^n\exp(-KV^nt),\qquad R(t,V)=\exp(-KV^nt) f ( t , V ) = K V n exp ( − K V n t ) , R ( t , V ) = exp ( − K V n t )
L ( V ) = 1 K V n , λ ( V ) = K V n L(V)=\frac{1}{KV^n},\qquad \lambda(V)=KV^n L ( V ) = K V n 1 , λ ( V ) = K V n
MLE 解包括 K K K n n n β = 1 \beta=1 β = 1
通用对数线性(GLL)模型将寿命表示为一个或多个变换后应力变量的函数:
L ( X ) = exp ( α 0 + ∑ j = 1 p α j X j ) L(\mathbf{X})=\exp\left(\alpha_0+\sum_{j=1}^{p}\alpha_jX_j\right) L ( X ) = exp ( α 0 + ∑ j = 1 p α j X j )
其中,X = ( X 1 , X 2 , … , X p ) \mathbf{X}=(X_1,X_2,\ldots,X_p) X = ( X 1 , X 2 , … , X p ) α 0 , α 1 , … , α p \alpha_0,\alpha_1,\ldots,\alpha_p α 0 , α 1 , … , α p
对于一个应力变量,GLL 模型变为 L ( X ) = exp ( α 0 + α 1 X ) L(X)=\exp(\alpha_0+\alpha_1X) L ( X ) = exp ( α 0 + α 1 X ) X X X
X = 1 / V X=1/V X = 1/ V C = exp ( α 0 ) C=\exp(\alpha_0) C = exp ( α 0 ) B = α 1 B=\alpha_1 B = α 1 X = ln ( V ) X=\ln(V) X = ln ( V ) K = exp ( − α 0 ) K=\exp(-\alpha_0) K = exp ( − α 0 ) n = − α 1 n=-\alpha_1 n = − α 1 X = V X=V X = V 对于使用条件和加速条件下的变换应力向量 X u \mathbf{X}_u X u X a \mathbf{X}_a X a
A F = L ( X u ) L ( X a ) = exp [ ∑ j = 1 p α j ( X j u − X j a ) ] AF=\frac{L(\mathbf{X}_u)}{L(\mathbf{X}_a)}=\exp\left[\sum_{j=1}^{p}\alpha_j(X_{ju}-X_{ja})\right] A F = L ( X a ) L ( X u ) = exp [ ∑ j = 1 p α j ( X j u − X ja ) ]
考虑一个以温度和电压为应力的 ALT 试验。假设温度服从 Arrhenius 关系,而电压服从逆幂律关系。示例数据如下。
温度和电压应力下的 ALT 示例数据
F/S 区间起点 区间终点 温度 (K) 电压 (V)
F 65 65 300 5 F 77 77 300 5 F 90 90 300 5 F 90 110 300 5 F 90 110 300 5 S 110 110 300 5 S 110 110 300 5 S 110 110 300 5 F 35 35 300 10 F 40 40 300 10 F 43 43 300 10 F 49 49 300 10 F 55 55 300 10 S 55 55 300 10 S 55 55 300 10 F 6.5 6.5 400 5 F 8 8 400 5 F 8.8 8.8 400 5 F 10 10 400 5 F 12 12 400 5
F 表示失效观测,S 表示暂停观测。区间起点与终点不同的记录为区间删失观测。
应力变量变换为:温度采用 X 1 = 1 / V 1 X_1=1/V_1 X 1 = 1/ V 1 X 2 = ln ( V 2 ) X_2=\ln(V_2) X 2 = ln ( V 2 )
温度和电压应力变换示例
F/S 起点 终点 V1 (K) V2 (V) X1 = 1/V1 X2 = ln(V2)
F 65 65 300 5 0.003333 1.609438 F 77 77 300 5 0.003333 1.609438 F 35 35 300 10 0.003333 2.302585 F 40 40 300 10 0.003333 2.302585 F 6.5 6.5 400 5 0.002500 1.609438 F 8 8 400 5 0.002500 1.609438
GLL-Weibull 模型 对于具有共同形状参数 β \beta β
f ( t , X ) = β η ( X ) [ t η ( X ) ] β − 1 exp [ − ( t η ( X ) ) β ] f(t,\mathbf{X})=\frac{\beta}{\eta(\mathbf{X})}\left[\frac{t}{\eta(\mathbf{X})}\right]^{\beta-1}\exp\left[-\left(\frac{t}{\eta(\mathbf{X})}\right)^\beta\right] f ( t , X ) = η ( X ) β [ η ( X ) t ] β − 1 exp [ − ( η ( X ) t ) β ]
R ( t , X ) = exp [ − ( t η ( X ) ) β ] , η ( X ) = L ( X ) R(t,\mathbf{X})=\exp\left[-\left(\frac{t}{\eta(\mathbf{X})}\right)^\beta\right],\qquad \eta(\mathbf{X})=L(\mathbf{X}) R ( t , X ) = exp [ − ( η ( X ) t ) β ] , η ( X ) = L ( X )
对于 p p p α 0 , α 1 , … , α p \alpha_0,\alpha_1,\ldots,\alpha_p α 0 , α 1 , … , α p β \beta β
GLL-对数正态模型 对于具有共同对数尺度标准差 σ \sigma σ
f ( t , X ) = 1 t σ 2 π exp { − 1 2 [ ln t − μ ( X ) σ ] 2 } f(t,\mathbf{X})=\frac{1}{t\sigma\sqrt{2\pi}}\exp\left\{-\frac{1}{2}\left[\frac{\ln t-\mu(\mathbf{X})}{\sigma}\right]^2\right\} f ( t , X ) = t σ 2 π 1 exp { − 2 1 [ σ l n t − μ ( X ) ] 2 }
R ( t , X ) = 1 − Φ [ ln t − μ ( X ) σ ] , μ ( X ) = ln L ( X ) = α 0 + ∑ j = 1 p α j X j R(t,\mathbf{X})=1-\Phi\left[\frac{\ln t-\mu(\mathbf{X})}{\sigma}\right],\qquad \mu(\mathbf{X})=\ln L(\mathbf{X})=\alpha_0+\sum_{j=1}^{p}\alpha_jX_j R ( t , X ) = 1 − Φ [ σ l n t − μ ( X ) ] , μ ( X ) = ln L ( X ) = α 0 + ∑ j = 1 p α j X j
对于 p p p α 0 , α 1 , … , α p \alpha_0,\alpha_1,\ldots,\alpha_p α 0 , α 1 , … , α p σ \sigma σ
GLL-指数模型 对于指数寿命分布,L ( X ) L(\mathbf{X}) L ( X ) λ ( X ) = 1 / L ( X ) \lambda(\mathbf{X})=1/L(\mathbf{X}) λ ( X ) = 1/ L ( X )
f ( t , X ) = 1 L ( X ) exp [ − t L ( X ) ] , R ( t , X ) = exp [ − t L ( X ) ] f(t,\mathbf{X})=\frac{1}{L(\mathbf{X})}\exp\left[-\frac{t}{L(\mathbf{X})}\right],\qquad R(t,\mathbf{X})=\exp\left[-\frac{t}{L(\mathbf{X})}\right] f ( t , X ) = L ( X ) 1 exp [ − L ( X ) t ] , R ( t , X ) = exp [ − L ( X ) t ]
L ( X ) = exp ( α 0 + ∑ j = 1 p α j X j ) , λ ( X ) = exp ( − α 0 − ∑ j = 1 p α j X j ) L(\mathbf{X})=\exp\left(\alpha_0+\sum_{j=1}^{p}\alpha_jX_j\right),\qquad \lambda(\mathbf{X})=\exp\left(-\alpha_0-\sum_{j=1}^{p}\alpha_jX_j\right) L ( X ) = exp ( α 0 + ∑ j = 1 p α j X j ) , λ ( X ) = exp ( − α 0 − ∑ j = 1 p α j X j )
对于 p p p α 0 , α 1 , … , α p \alpha_0,\alpha_1,\ldots,\alpha_p α 0 , α 1 , … , α p β = 1 \beta=1 β = 1
ALT 分析将寿命分布与物理上适用的寿命–应力关系结合起来。主要分析步骤为:
准备数据,包括每个试件的观测类型和应力值。
确认各试验条件所加速的是同一种失效机理。
选择应力变量数量以及每个应力的变换形式。
选择基础寿命分布,例如 Weibull、对数正态或指数分布。
采用最大似然法估计模型参数,并在外推至使用条件之前评估寿命分布和寿命–应力假设是否适用。